本文介绍Elasticsearch的Index和Mapping,要学习Elasticsearch,我觉得首先要知道ES是如何处理数据的,这样才能更好的去构建索引和搜索的模型,当然更深层次的是学习ES底层Luence如果进行索引管理的,这个后面在总结,这里只是先简单的学习ES的Index模块和Mapping是如何工作的,我们可以怎么通过他们来进行doc的字段映射,索引,更高效的管理我们存储的数据。
Index Modules
我们先了解一下ES的Index Modules,索引模块负责每个Index的创建,以及控制和索引相关的所有操作。
每一个索引都拥有索引层面的单独配置,这个通用层面的索引配置分为两类:
- static:只能在index被创建时或者关闭时设置,或者通过 update-index-settings 的API中通过
"reopen" : true参数在自动关闭或者开启时进行设置。 - dynamic:可以在索引存在期间通过 update-index-settings进行设置的。
WARNNING:在关闭的索引上,修改static或者dynamic设置会导致不一致的结果,如果你不删除和重新创建Index
Static Index设置
static的索引设置手册上有比较详细的说明,这里列几个比较常见的:
index.number_of_shards
一个索引包含的主分片的个数,默认为1。只能在索引创建时设置,在关闭的索引上也不能改变。
ES中的shard(分片)是一个索引和查询的最小的工作单元,每个shard对应一个底层的Lucene实例,每一个Index都会被分成多个shard,每个doc通过路由计算会落在一个特定的shard上。相同的doc不会分布在多个主分片上,但会复制到不同的副本分片上。
Index的主分片用于储存数据,副本分片:冗余数据,用于提高可用性。主分片和副本分片可以分布在不同的节点上,充分利用集群的水平扩展能力。
在索引过程中,Elasticsearch首先在primary shard上执行索引和持久化操作,完成之后将数据直接发送到replica shards,通过这种方式使primary和replica数据同步。分片太多或太少都会影响集群性能,需要根据数据量适当选择分片数。过多分片会导致过多的开销,过少分片会限制并行能力。
下面是一个ES的Index,Shard,Node的结构图:
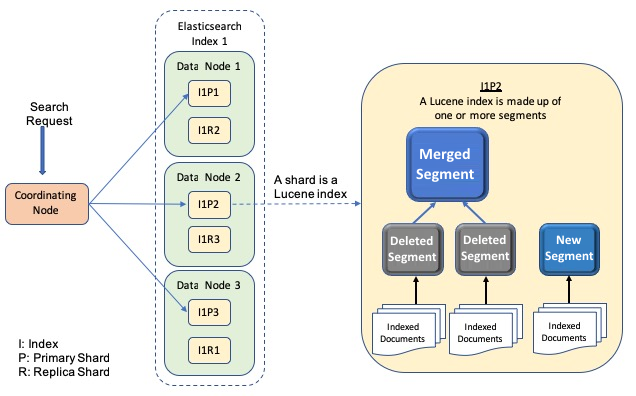
疑问:一个search请求会同时发往同一个主shard对应的副本shard吗?如果是,那么不是白白增加了系统的负载吗?
index.number_of_routing_shards
用于控制文档路由到哪个主分片的路由因子,为什么不直接用index.number_of_shards来做路由,主要有两个原因:
- 保证路由的均匀:将
number_of_routing_shards设置为高于number_of_shards的值,可以让路由算法的哈希空间更大,从而提高哈希的均匀分布性,避免路由倾斜导致的负载不均。 - 路由的一致性:路由因子和分片数量解耦,可以保证在分片数量修改时,无需重建整个索引,之前的shard的索仍然路由一致。
该设置默认值取决于索引主分片的个数,默认值需要将索引能够为2的倍数,最大为1024。
index.codec
存储的数据的压缩编码,默认采用LZ4压缩编码。
Dynamic Index设置
dynamic的索引设置手册上有比较详细的说明,这里列几个比较常见的:
index.number_of_replicas
每个主分片对应的副本分片个数,默认为1。如果设置为0,会导致在Node在重启过程或者数据损坏情况下的可用性受损。
index.auto_expand_replicas
自动根据集群中数据Node的数量来调整索引的副本分片的数量,以适应集群数据节点数量的变化,可以设置扩展范围(lower_bound-upper_bound),允许自动扩展的上下限,upper_bound允许设置为:"all",表示副本分片数量会扩展至数据节点数量减1,而不考虑分片分配规则。
副本分片自动调整一定程度上简化了运维,且能提高写吞吐和查询性能。但也要注意,该参数会增加部分内存开销,同时如果upper_bound设置过高,可能会降低索引的可用性。因此使用时需要合理设置扩展范围。
index.refresh_interval
该参数设置了索引刷新操作的频率,默认1s。这里的索引刷新操作是指:让已经索引的数据对搜索可见。
如果设置为-1,表示禁用定时刷新,这种只能手动刷新,或借助搜索时的实时刷新,这样会影响搜索性能。
注意:如果该设置没有显示设置(即使用默认值),一个分片在超过index.search.idle.after时间内没有搜索请求,就会进入空闲优化状态,即跳过自动刷新操作以优化性能,如果一个搜索请求命中这种状态的shard,将会触发shard的刷新,然后才会继续执行搜索请求。这里可以通过显示设置参数为1s等值,来禁用此行为。
建议如果业务对搜索实时性要求比较高,显示设置
index.refresh_interval为1,禁用空闲优化状态。
如下:
jsonPUT codev_conscribe_idle_player_dev1/_settings
{
"index.refresh_interval" : "1s"
}
这里的索引刷新操作在底层到了做了哪些事情(By Claude):
-
从内存缓存区提交数据 新索引的数据首先被缓存在内存缓冲区,称为"内存段(memory segment)"。刷新时会将这些内存段的数据提交到文件系统缓存。
-
写入全局反向索引 将内存段中的反向索引数据写入全局反向索引文件,使其对搜索可见。反向索引是搜索的核心数据结构。
-
生成分段文件 内存段中的其他索引数据会被写入到新的分段(segment)文件。这些分段文件持久存储在磁盘上。
-
更新元数据 刷新后,Elasticsearch会更新分片的元数据(commit point),使其指向新生成的分段文件。这一步是原子操作。
-
打开新分段以供查询 搜索线程会重新打开分片的索引文件,使新的分段数据也能被查询到。
如果没有刷新操作,那么新索引的数据只存在于内存缓冲区中,搜索线程是无法直接访问这部分内存数据的。刷新的目的就是将内存中的新增索引数据持久化并对外可见。所以Elasticsearch默认定期自动刷新,以确保数据在合理的延迟时间内就能被搜索到。
通过刷新操作,Elasticsearch在尽可能减小写入延迟的同时,也确保新数据能被及时地投入使用,这种内存数据和持久化索引文件相结合的设计,实现了写入性能和查询实时性的平衡。
index.search.idle.after
该参数定义了一个分片在多久没有接受搜索或者获取请求的时间,被认为是进入了搜索空闲状态。默认值是30s,也就是如果一个分片在index.search.idle.after 秒内没有看到搜索流量将不会自动进行索引刷新,直到它们接收到一个搜索请求。
这个参数可以帮助提高 Elasticsearch 的资源利用率。当没有活动的查询时,Elasticsearch 可以将搜索线程池中的线程空闲下来,以便用于其他任务。
如果你发现搜索空闲的分片较慢,有两种方案:
- 一个方案可以显式地将 index.refresh_interval 设置为 1 秒或其他值,以禁止进入空闲优化状态。
- 另一个解决方案设置 index.search.idle.after 从 30s 更新为一个较大的值,如 3600s。这样可以使空闲搜索更快。
这里需要注意:降低 index.search.idle.after 参数的值可能会导致搜索延迟增加,因为 Elasticsearch 需要在收到查询时重新启动搜索线程。提高 index.search.idle.after 参数的值可能会导致资源浪费,因为 Elasticsearch 会保留空闲的搜索线程。这里主要取决业务场景是否对搜索延迟敏感。
index.routing.allocation.enable
该参数用于控制索引在分片上的分配行为,主要有以下几个值:
"all":默认值,表示允许索引分配在所有shard上,即primary shard和replica shard。"primaries":只允许索引分配在primary shard上。适用只需要索引数据而不需要冗余的场景。"new_primaries":只允许索引分配在新的创建的primary shard上,现有的primary shard和replica shard都不会被分配。适用于做数据迁移等操作。"none":该索引的不会被分配到所有shard上,实际是让所有的所有数据离线,用于临时关闭读写以便维护。
其他索引模块
除了上面的一些通用索引设置,还有一些专门的索引模块设置,用于设置索引过程设计到的不同模块,主要有以下:
- Analysis模块:用于配置分析器链,定义分词器,词单元过滤器等文本分析过程。可以在索引级别为不同字段指定不同的分析器链。
- Index shard allocation模块:控制分片如何在集群节点间分配,包括分片分配启用、总负载、节点属性约束等过滤规则。
- Mapping模块:设置是否开启动态映射检测、是否允许数据冲突等。也可以预先定义字段映射的具体规则。
- Merging模块:用于微调后台数据合并的行为,如合并策略、合并计划等,影响索引存储空间。
- Similarities模块:自定义相似度算法,用于调整不同查询字段的打分机制。
- Slowlog模块:设置何种查询和获取请求应记录为慢请求,以及采样频率等。
- Store模块:配置存储数据和索引文件时使用何种文件系统,如fs、simplefs等。
- Translog模块:控制事务日志相关的设置,如同步间隔、保留时间等,影响索引持久化。
- History retention模块:设置索引历史操作的保留策略和时间。
- Indexing pressure模块: 配置缓存刷新和合并等行为,主动调节写入压力。
映射(Mapping)
mapping描述了一个document包含的各个字段的数据是如何存储和索引的;熟悉mapping相关概念和设计能很好的帮助我们更好的设计我们的程序和数据。
Elasticsearch每个document都是一个field集合,每个field都有它自己的数据类型;当你创建一个mapping定义映射你的document的时候,mapping需要包含映射的document的字段列表,mapping的定义同样可以包含一些metadata fields。
Elasticsearch提供了两种mapping来进行document field的映射,它们各有特长;
- Dynamic mapping
Dynamic mapping是Elasticsearch提供的默认映射规则,在一个JSON document被index的时候,不需要事先进行Index的创建,不需要定义mapping类型,也不需要定义document的各个fields,Elasticsearch会自动创建Index, mapping type,fields;
关于Dynamic mapping中的各个fields是如何识别和定义的,可以参考Dynamic field mapping;
动态映射还支持通过dynamic templates 来通过条件匹配来动态的决定field映射的类型。
- Explicit mapping
Explicit mapping允许我们准确的定义document的各个field如何进行识别和定义,例如:
- 哪些string的fields需要被视为纯文本的fields;
- 哪些字段是数值,日期,或者地理位置数据;
- 日期数据的格式;
- 针对动态增加的fields定义相关的规则进行映射识别;
动态映射简单快捷,合适原型和测试场景。显式映射强制执行数据规范,适合生产环境。两种方式可混合使用,比如为核心字段设置显式mapping,其他字段动态映射。
Field data type
Elasticsearch提供了丰富的数据类型种类,能够有效地对各种形式的数据进行建模和索引,以便高效的数据写入、存储、搜索和分析。
每个document都是一个field集合,每个field都有它自己的数据类型;不同的类型决定了ES如何被分析和索引,例如一个JSON string数据类型可以被标记为text或者keyword字段类型,这两个字段类型的差异是:
text字段:会被analyzed,分析过程包括:分词,格式化(小写),去除停用词等,然后建立倒排索引,用于全文本检索;keyword字段:不会被分析,直接作为一个整体建立索引,不能全文本检索,适合过滤,排序和聚合,用于精确匹配查询。
其实,Elasticsearch的字段类型族主要分为:
text类型族:全文检索;keyword类型族:关键词检索,适合过滤,排序和聚合;- 其他类型族:每个族只有一个字段类型,例如
boolean类型族只有一个boolean字段类型,这种也都是精确匹配,类似keyword类型族。
下面是Elasticsearch的字段类型的一个大致分类:
| 大类 | 具体类型 | 类型含义 |
|---|---|---|
| 通用类型 | binary |
Base64编码的二进制数据 |
boolean |
true/false布尔值 | |
keyword |
关键词字符串,不分词 | |
numbers |
数值类型:long,integer,short,float等 |
|
date, date_nanos |
日期和纳秒级时间戳 | |
| 对象和关系类型 | object |
JSON对象 |
flattened |
将整个JSON对象作为单个字段值存储 | |
nested |
嵌套JSON对象,保留子字段关系 | |
join |
定义同索引文档间的父子关系 | |
| 结构化数据类型 | long_range, double_range, date_range, ip_range |
各种范围类型字段 |
ip |
IPv4和IPv6地址 | |
version |
语义化版本号 | |
murmur3 |
计算并存储值的Murmur3哈希 | |
| 聚合数据类型 | aggregate_metric_double |
预先聚合的数值指标 |
histogram |
预先聚合的数值直方图 | |
| 文本搜索类型 | text, annotated-text, match_only_text |
经过分析的全文本字段 |
completion, search_as_you_type |
用于自动补全建议的文本字段 | |
token_count |
统计文本分词数量的字段 | |
| 文档评分类型 | dense_vector, sparse_vector |
密集和稀疏浮点数向量 |
rank_feature, rank_features |
用于查询时结果增权的数值特征字段 | |
| 空间数据类型 | geo_point |
经纬度坐标点 |
geo_shape |
复杂的多边形等几何形状 | |
point, shape |
任意笛卡尔坐标系上的点和几何体 | |
| 其他 | percolator |
索引查询DSL表达式,用于反向查找 |
下面是一个简单的Elasticsearch新增一个doc的例子:
jsonPUT my-index-000001/_doc/1
{ ①
"region": "US",②
"manager": { ③
"age": 30,④
"name": { ⑤
"first": "John",⑥
"last": "Smith"
}
}
}
①:doc本身就是一个JSON object。Elasticsearch中,存储和索引的基本单位是doc,文档本身就是一个JSON对象。
②:名为"region"的字段,字段类型为text。
③:名为"manager"字段,字段类型为object。
④:名为"age"字段,字段类型为long。
⑤:名为"name"字段,字段类型为object。
⑥:名为"first"的字段,字段类型为text。
Array
Elasticsearch中有一个array的数据结构,但是它不是专门的字段类型,任何字段都可以0个或多个值,形成一个数组。array中所有的值必须是相同的字段类型,如下:
- an array of strings: [
"one","two"] - an array of integers: [
1,2] - an array of arrays: [
1, [2,3]] ,等价 [1,2,3] - an array of objects: [
{ "name": "Mary", "age": 12 },{ "name": "John", "age": 10 }]
Multi-fields
Elasticsearch中还有一个Multi-fields的特性,即一个字段可以用多重类型,它允许我们对同一个字段进行不同的索引,从而满足不同的应用场景。例如:
- 一个
string字段可以同时映射为text类型用于全文搜索,和keyword类型用于排序、聚合等操作。 - 一个
string字段同时使用standard分词器、english分词器和french分词器分别建立索引,用于不同语言环境的搜索。
如下是multi-fields的语法结构:
json"mappings": {
"properties": {
"field_name": {
"type": "data_type",
"fields": {
"subfield_name": {
"type": "subfield_data_type",
...
},
...
}
}
}
}
field_name是主字段的名称;data_type是主字段的数据类型,如text、keyword等;fields参数下面定义了一个或多个子字段;subfield_name是子字段的名称;subfield_data_type是子字段的数据类型;
多重类型字段中子字段的映射和主字段(或者父字段)的映射是完全隔离的,不会继承父字段的任何选项。多重类型字段不会修改_source原始数据。
如下用例:
jsonPUT my-index-000001/_doc/1
{
"full_text": "Quick Brown Foxes!"
}
了解完Dynamic mapping后就会知道,默认ES会针对JSON string数据类型同时映射为text主字段和keyword子字段,如下我们可以查看my-index-000001的mapping映射如下:
json{
"my-index-000001": {
"mappings": {
"properties": {
"full_text": {
"type": "text",
"fields": {
"keyword": {
"type": "keyword",
"ignore_above": 256}
}
}
}
}
}
}
可见,ES自动建立名字为keyword的子字段,且类型为"keyword",这里需要注意:所有针对"full_text"字段的搜索默认都是针对text主字段类型进行的,如果需要针对keyword子字段进行搜索,需要显示指定。如下:
jsonGET my-index-000001/_search
{
"query": {
"term": {
"full_text.keyword": "Quick Brown Foxes!"
}
}
}
Dynamic mapping
前面一节介绍了Elasticsearch支持的字段类型,前面也提到了Dynamic mapping和Explicit mapping,当然在业务中,我们更提倡通过Explicit mapping来明确doc的各个字段是如何进行映射和索引的,这样可以更高效。
下面介绍一下默认情况下:Dynamic mapping是如何进行doc的字段映射和索引的。
Dynamic mapping是Elasticsearch最重要的一个feature,它是ES提供的默认映射规则,在一个JSON document被index的时候,不需要事先进行Index的创建,不需要定义mapping类型,也不需要定义document的各个fields,Elasticsearch会自动创建Index, mapping type,fields;ES会自动检测doc的各个field,动态的向mapping中增加新的field。
Mapping的dynamic 参数控制Dynamic mapping的行为,默认是true,表示开启;下面是ES支持的doc的JSON数据类型如何自动进行mapping为field类型的列表,如果需要识别为其他字段类型,需要自定义Explicit mapping。
| JSON 数据类型 | "dynamic":"true" |
"dynamic":"runtime" |
|---|---|---|
null |
不添加字段 | 不添加字段 |
true 或 false |
boolean |
boolean |
double |
float |
double |
long |
long |
long |
object |
object |
不添加字段 |
array |
取决于数组中第一个非 null 值的类型 | 取决于数组中第一个非 null 值的类型 |
string(可检测为日期) |
date |
date |
string(可检测为数值) |
float 或 long |
double 或 long |
string(其他字符串) |
text,并添加 .keyword 子字段 |
keyword |
Dynamic的dynamic 参数有以下几个值:
dynamic 参数值 |
新字段处理方式 |
|---|---|
true (默认值) |
新字段将被添加到映射中 |
runtime |
新字段将作为运行时字段添加到映射中,不索引,查询时从_source加载 |
false |
新字段将被忽略,不会被索引或搜索,但会存在于_source中,不会添加到映射中 |
strict |
如果检测到新字段,将抛出异常并拒绝该文档,新字段必须手动添加到映射中 |
在定义Explicit mapping的时候,可以将dynmaic参数设置为strict,严格限制加入的doc的字段,对于一些业务来说会比较明确和高效,防止索引被异常膨胀,导致业务性能下降。
关于doc中的JSON string字段Elasticsearch提供了两种自动检测和映射的功能:
- 日期检测:默认开启,支持的日期格式
dynamic_date_formats为:"yyyy/MM/dd HH:mm:ss Z||yyyy/MM/dd Z"。也可以定制日期的格式。 - 数值检测:默认关闭,支持JSON string为数值类型时,映射为数值类型。
下面看一下一个简单的例子来看一下ES默认的Dynamic mapping,如下添加一个doc:
jsonPUT my-index-000001/_doc/1
{
"region": "US",
"manager": {
"age": 30,
"name": {
"first": "John",
"last": "Smith"
}
}
}
然后通过GET my-index-000001/_mapping获取Dynamic mapping自动生成的mapping如下:
json{
"my-index-000001": {
"mappings": {
"properties": {
"manager": {
"properties": {
"age": {"type": "long"},
"name": {
"properties": {
"first": {
"type": "text",
"fields": {"keyword": {"type": "keyword", "ignore_above": 256}}
},
"last": {
"type": "text",
"fields": {"keyword": {"type": "keyword", "ignore_above": 256}}
}
}
}
}
},
"region": {
"type": "text",
"fields": {"keyword": {"type": "keyword", "ignore_above": 256}}
}
}
}
}
}
可以看到上面默认Dynamic mapping默认会为string字段建立Multi-fields多重类型,同时映射为text类型用于全文搜索,和keyword类型用于排序、聚合等操作。可以通过Elasticsearch提供的DSL语法来进行搜索,如下:
textGET my-index-000001/_search
{
"query": {
"match": {
"manager.name.first": "John"
}
}
}
Dynamic templates
Elasticsearch支持动态模板(Dynamic templates)的特性,允许修改Dynamic mapping默认的字段映射行为。
只有Dynamic mapping生效的时候,Dynamic tempaltes才会生效,即
"dynamic": true or runtime
Dynamic templates可以根据匹配条件,自动为匹配的字段应用预先定义好的映射配置,匹配条件的格式定义如下:
match_mapping_type和unmatch_mapping_type:用来匹配指定的JSON数据类型,也就是前面Dynamic mapping一节列出来的JSON数据类型。如果类型匹配,才有可能适配此模版;match和unmatch:用来模式匹配字段名是否符合条件;path_match和path_unmatch:用来全路径匹配;
如下,在索引my-index-000001下,定义了一个Dynamic templates,模版名字为:strings_as_ip,匹配JSON 数据类型为"string"的字段,匹配字段名为ip开头的字段,都匹配之后,将该字段映射为ip字段类型。
jsonPUT my-index-000001/
{
"mappings": {
"dynamic_templates": [
{
"strings_as_ip": {
"match_mapping_type": "string",
"match": "ip*",
"runtime": {
"type": "ip"
}
}
}
]
}
}
详细的说明可以参考官方手册。总的来说,动态模板提供了细粒度的控制,允许根据数据类型、字段名和路径模式自定义动态字段的映射行为,是处理异构和复杂数据的利器。合理使用动态模板可以大幅提升映射质量和维护效率
Explicit mapping
虽然Elasticsearch内置的Dynamic mapping可以很方便的根据一些内置规则自动推断字段映射,但这种方式存在一些缺陷:
- 动态映射无法完全推断出数据的语义,可能导致映射不准确。
- 默认规则可能无法满足特殊需求,比如特定分词器、多字段等。
- 频繁的动态映射会影响集群性能。
显然业务开发者比Elasticsearch本身的推断更清楚数据的类型,显示的定义字段映射可以保证:
- 准确的数据类型映射;
- 高级特性的支持:多字段映射、自定义分词器、数字格式化等高级特性只能通过显式映射来配置。这些对优化搜索相关性、提升用户体验至关重要。
- 集群稳定性:动态映射会导致集群元数据的频繁变更,影响集群稳定性。显式映射则可以将这种开销降到最低。
- 性能优化:通过映射优化,可以控制分词、过滤、存储等行为,提升查询和索引性能。
下面我们看一下例子,创建一个Index的Explicit mapping:
jsonPUT /my-index-000001
{
"mappings": {
"dynamic": "strict",
"properties": {
"age": { "type": "integer" },
"email": { "type": "keyword" },
"name": { "type": "text" }
}
}
}
通过GET my-index-000001/_mapping来获取Explicit mapping的配置如下:
json{
"my-index-000001": {
"mappings": {
"dynamic": "strict",
"properties": {
"age": {"type": "integer"},
"email": {"type": "keyword"},
"name": {"type": "text"}
}
}
}
}
然后可以就可以写入doc了:
jsonPUT my-index-000001/_doc/1
{
"name": "walkerdu",
"age": 18,
"email": "[email protected]"
}
可以向创建的Explicit mapping中增加某个字段的映射,如下:新增一个employee-id字段映射,映射为keyword字段类型,且mapping参数index置为false,表示该字段被存储,但是不会被索引,也不能被搜索使用。
jsonPUT /my-index-000001/_mapping
{
"properties": {
"employee-id": { "type": "keyword", "index": false}
}
}
注意:除了 mapping parameters,无法修改现有mapping的已有的字段映射,因为这可能导致已索引数据失效。如果要修改已有Index的mapping,可以创建一个新的Index,然后将旧Index的数据 reindex到新的Index中。如果想要重命名一个mapping的已有的field,可以通过 alias创建一个新的字段映射,来达到重命名的效果。
Runtime fields
在Elasticsearch中,Runtime fields(运行时字段)是一种动态生成的字段,它们不会存储在磁盘上,而是在查询时基于现有文档的值计算出来。Runtime fields提供了以下主要好处:
- 无需重新索引即可添加新字段:传统的字段映射需要在索引创建时就定义好。如果需要新增一个字段,通常需要重新索引所有数据。而Runtime fields可以在不重新索引的情况下动态添加新字段。
- 节省磁盘空间:Runtime fields的值不会被存储在磁盘上,而是在查询时根据原始数据计算得到。
Elasticsearch中提供了两种方式来定义Runtime fields:在索引映射中定义和在搜索请求中定义。
索引映射中定义
我们可以通过在mapping的定义中添加runtime结构来定义运行时字段,通过索引映射定义runtime fields我们又可以通过两种方式来进行定义:
- 通过Painless script来创建runtime字段。该脚本可以访问完整的doc上下文,包括
_source和params._source,以及已经映射的字段和值,在查询的时候Painless脚本会在命中的docs中执行和生成运行时的字段。 - 直接在mapping中定义runtime字段。当没有script提供的时候,Elasticsearch会在查询时隐式地在文档的
_source字段中寻找与运行时字段同名的字段,如果存在该字段,就将其值作为运行时字段的值返回。如果_source中不存在同名字段,那么响应结果中就不会包含该运行时字段的值。
如下,通过mapping来定义runtime field,下面定义了两个runtime字段,一个包含script(用来显示星期几),一个不包含script
jsonPUT my-index-000001/
{
"mappings": {
"runtime": {
"day_of_week": {
"type": "keyword",
"script": {
"source": "emit(doc['@timestamp'].value.dayOfWeekEnum.getDisplayName(TextStyle.FULL, Locale.ROOT))"
}
},
"name" : {"type": "keyword"}
},
"properties": {
"@timestamp": {"type": "date"}
}
}
}
然后插入两个doc
jsonPUT my-index-000001/_doc/1
{
"name": "walkerdu",
"age": 18,
"email": "[email protected]",
"@timestamp": "2023-05-01T10:25:43.592Z"
}
PUT my-index-000001/_doc/2
{
"name": "balabala",
"age": 18,
"email": "[email protected]",
"@timestamp": "2023-05-02T10:25:43.592Z"
}
然后查询:
jsonGET my-index-000001/_search/
{
"fields": ["day_of_week", "name"]
}
{
"took": 19,
"timed_out": false,
"_shards": { "total": 1, "successful": 1, "skipped": 0, "failed": 0 },
"hits": {
"total": { "value": 2, "relation": "eq" },
"max_score": 1,
"hits": [
{
"_index": "my-index-000001", "_id": "2", "_score": 1,
"_source": { "name": "balabala", "age": 18, "email": "[email protected]", "@timestamp": "2023-05-02T10:25:43.592Z" },
"fields": { "name": ["balabala"], "day_of_week": ["Tuesday"] }
},
{
"_index": "my-index-000001", "_id": "1", "_score": 1,
"_source": { "name": "walkerdu", "age": 18, "email": "[email protected]", "@timestamp": "2023-05-01T10:25:43.592Z" },
"fields": { "name": ["walkerdu"], "day_of_week": ["Monday"] }
}
]
}
}
查询请求中定义
可以在查询请求中,通过runtime_mappings段来创建runtime fields(只在此条查询中有效),runtime_mappings段内关于runtime字段的定义语法和在在 mappings中定义是一样的,只是定义的段名从runtime 变成了runtime_mappings。
如下:根据索引中所有doc的@timestamp字段计算出day_of_week星期几的runtime field,并根据此runtime field进行聚合分类。
jsonGET my-index-000001/_search
{
"runtime_mappings": {
"day_of_week": {
"type": "keyword",
"script": {"source": "emit(doc['@timestamp'].value.dayOfWeekEnum.getDisplayName(TextStyle.FULL, Locale.ROOT))"}
}
},
"aggs": {
"day_of_week": {
"terms": {"field": "day_of_week"}
}
}
}
Metadata fields
Elasticsearch中,每一个Index的doc创建的时候都会自动生成一些元数据,例如:_index和_id,有些元数据字段还可以在mapping创建的时候可以定制。元数据分类如下:
| 类别 | 字段 | 描述 |
|---|---|---|
| 身份元数据字段 | _index |
文档所属的索引 |
_id |
文档ID | |
| 文档源元数据字段 | _source |
代表文档正文的原始JSON |
_size |
_source字段的大小(字节),由mapper-size插件提供 |
|
| 文档计数元数据字段 | _doc_count |
用于存储预聚合数据时的文档计数的自定义字段 |
| 索引元数据字段 | _field_names |
文档中包含非空值的所有字段 |
_ignored |
由于ignore_malformed在索引时被忽略的所有字段 |
|
| 路由元数据字段 | _routing |
将文档路由到特定分片的自定义路由值 |
| 其他元数据字段 | _meta |
应用程序特定的元数据 |
_tier |
文档所属索引的当前数据层首选项 |
例如之前创建的doc,可以直接查询看看对应的元数据
jsonGET my-index-000001/_doc/1
{
"_index": "my-index-000001",
"_id": "1",
"_version": 1,
"_seq_no": 0,
"_primary_term": 1,
"found": true,
"_source": {
"name": "walkerdu",
"age": 18,
"email": "[email protected]",
"@timestamp": "2023-05-01T10:25:43.592Z"
}
}
也可以查看指定的元数据:
jsonGET my-index-000001/_doc/1?filter_path=_index,_id
{
"_index": "my-index-000001",
"_id": "1"
}
Mapping parameters
Mapping parameters是在定义映射的时候可以指定一组配置选项,用于控制字段的映射,优化存储和搜索等,下面是ES提供的所有Mapping parameters及其功能描述:
| 参数 | 描述 |
|---|---|
analyzer |
指定在对字段值进行分词及构建倒排索引时使用的分词器。不同的分词器可以根据语言和需求对字段值进行分词和标记化。 |
coerce |
尝试将接收到的字段值转换为映射中定义的数据类型。比如将字符串"1"转换为整数1。当数据源中的数据类型与映射中定义的不一致时很有用。 |
copy_to |
将当前字段的值复制到其他目标字段中,使目标字段的值成为当前字段值的联合。常用于将多个字段的值组合到一个字段中进行搜索。 |
doc_values |
启用后将为字段构建一个以磁盘列方式存储的数据结构,用于快速排序、聚合和基于字段值的脚本访问,可以大幅提高这些操作的性能。 |
dynamic |
控制是否可以动态添加新的字段到现有映射中。设置为false可以防止无意中新增字段,true则允许动态新增,strict需要显式定义字段映射。 |
eager_global_ordinals |
启用后将为该字段预构建一个全局的有序值列表,提高了排序和基于值的运算性能,但会消耗更多内存。 |
enabled |
用于标记映射中的字段是启用状态还是禁用。如果禁用,该字段将不会被索引也不能被查询和聚合。通常用于临时禁用字段。 |
fielddata |
控制在需要执行排序、聚合等基于字段值的操作时,是否应该为字段在每个分片上额外构建一个基于内存的数据结构,以提高性能。 |
fields |
定义多字段映射,允许为同一个字段值构建多个不同的字段,比如一个做全文索引,另一个做精确值索引,以满足不同查询场景的需求。 |
format |
指定解析日期字段值时使用的日期格式,如yyyy-MM-dd。Elasticsearch将根据该格式解析字段值并建立索引。 |
ignore_above |
设置字段值的最大可索引长度,超过该长度的文本将被完全忽略而不会被索引。用于避免过长的字段值占用过多索引空间。 |
ignore_malformed |
指定在遇到无法被解析的字段值时如何处理。设置为true将忽略该值而不是引发异常,但可能导致部分数据丢失。 |
index_options |
控制在构建倒排索引时记录哪些信息,如记录词条位置、记录词频等,可以平衡索引精度和索引占用空间。 |
index_phrases |
启用后将在倒排索引中增加两元语汇和三元语汇的索引,以支持对这些短语的搜索,但会增加索引的磁盘占用。 |
index_prefixes |
控制是否为字段建立前缀索引,用于加速前缀查询,但会增加索引占用空间。可设置建立的最小/最大前缀长度。 |
index |
控制字段值是否应该被索引到倒排索引中,以允许基于该字段的查询操作。设置为false可以节省索引空间。 |
meta |
允许为字段添加一些元数据信息,这些信息将会随同文档一起被存储,但不会被索引,仅供查询和访问时使用。 |
normalizer |
指定在索引和查询该字段时应该如何对其值执行规范化,以支持对变体形式的搜索,比如大小写折叠等。 |
norms |
启用后将为字段值存储规范化因子,用于计算该字段值相对于其他文档的权重,以提高相关度评分的准确性。 |
null_value |
指定当字段值为null时,使用该配置的值代替null值进行索引,以避免null引起的异常或错误。 |
position_increment_gap |
影响多值字段值之间在倒排索引中的位置增量,增大该值可以为字段值之间留有"空位",提高特定短语查询的精度。 |
properties |
用于定义嵌套对象类型字段的字段映射。对象类型字段的映射定义需要在properties下给出。 |
search_analyzer |
定义在搜索时使用的分析器。这个分析器用于在查询字符串上执行全文搜索。它会影响如何分割查询字符串并处理查询中的词语。 |
similarity |
定义用于计算相关性得分的相似性算法。这用于排名,以确定文档与查询的相关性。常用的相似度算法包括BM25和TF-IDF。 |
subobjects |
启用将对象内部的嵌套文档作为单独的隐藏文档进行索引和搜索。这对于将一个文档拆分为多个嵌套子文档很有用。 |
store |
控制在索引中存储实际的_source字段值。默认为true,表示完整的源文档将存储在索引中。如果设置为false,则不存储源文档,可以节省磁盘空间,但你将无法直接从索引中检索文档。 |
term_vector |
用于为文档字段存储词条向量。词条向量包含了文档中词语的位置和频率信息,可用于高亮搜索词等操作。支持设置position_increment_gap参数控制向量信息的精度。 |
这里介绍两个参数选项 :null_value和index
null_value参数
null_value用在当映射的字段值为null时,使用该配置的值代替null值进行索引,以避免null引起的异常或错误。注意:只有当doc对应的字段显示的设置为"field_name" : null的时候,该自动替换才会生效,如果doc内没有显示设置改字段,或者字段value为空数组[],空字符串时,都不会发生替换。如下测试:
jsonPUT my-index-000001
{
"mappings": {
"properties": {
"sex": {
"type": "short",
"null_value": 1
}
}
}
}
PUT my-index-000001/_doc/1
{
"name": "walkerdu",
"age": 18,
"email": "[email protected]",
"@timestamp": "2023-05-01T10:25:43.592Z",
"sex":null
}
上面先设置mapping字段映射的null_value,然后插入doc中显示设置"sex" : null,然后查询"sex" : 1的doc如下:
jsonGET my-index-000001/_search
{
"query": {
"term": {"sex": 1}
}
}
可以查看,返回结果如下:
json{
"took": 1,
"timed_out": false,
"_shards": {"total": 1, "successful": 1, "skipped": 0, "failed": 0},
"hits": {
"total": {"value": 1, "relation": "eq"},
"max_score": 1,
"hits": [
{
"_index": "my-index-000001",
"_id": "1",
"_score": 1,
"_source": {
"name": "walkerdu",
"age": 18,
"email": "[email protected]",
"@timestamp": "2023-05-01T10:25:43.592Z",
"sex": null
}
}
]
}
}
从上面的返回结果我们可以看出:null_value的映射参数只会影响数据如何被索引,而不会修改doc的_source中该字段的null值。也就是说Elasticsearch只会在建立索引的过程中使用null_value的值替换对应字段的null。
如何查看被null_value替换的默认值呢,我们知道被替换的默认值,只存在于索引中,而不是_source中,这里我们可以通过查询时候的fields参数来直接从索引数据结构中获取对应字段的值。如下:
jsonGET my-index-000001/_search/
{
"fields": ["sex"]
}
可以得到如下结果:
json{
"took": 0,
"timed_out": false,
"_shards": {"total": 1, "successful": 1, "skipped": 0, "failed": 0},
"hits": {
"total": {"value": 1, "relation": "eq"},
"max_score": 1,
"hits": [
{
"_index": "my-index-000001",
"_id": "1",
"_score": 1,
"_source": {
"name": "walkerdu",
"age": 18,
"email": "[email protected]",
"@timestamp": "2023-05-01T10:25:43.592Z",
"sex": null
},
"fields": {"sex": [1]}
}
]
}
}
index参数
index选项用于控制字段是否需要被索引,默认是true,如果设置了false,那么对应的字段就不会建立索引,也无法被搜索,如下,设置mapping,family.wife字段不建立索引:
jsonPUT my-index-000001
{
"mappings": {
"properties": {
"family": {
"properties": {
"wife": {"type": "text", "index" : false},
"son": {"type": "text", "index" : true}
}
}
}
}
}
插入如下的doc:
jsonPUT my-index-000001/_doc/1
{
"name": "walkerdu",
"age": 18,
"email": "[email protected]",
"@timestamp": "2023-05-01T10:25:43.592Z",
"family": {
"wife": "A",
"son": "B"
}
}
如果要搜索family.wife的时候ES会返回没有索引的错误:
jsonGET my-index-000001/_search
{
"query": {
"match": {
"family.wife": "A"
}
}
}
{
"error": {
"root_cause": [
{
"type": "query_shard_exception",
"reason": "failed to create query: Cannot search on field [family.wife] since it is not indexed.",
"index_uuid": "9NFoncsbRrygsBQqBwCWyA",
"index": "my-index-000001"
}
],
}
Mapping的限制
Elasticsearch中对Mapping有很多的限制设置,用于限制单个映射定义的大小和复杂性,以防止过大的映射定义导致集群出现性能问题或内存问题。如下是Mapping的所有设置和对应的描述:
| 设置 | 描述 |
|---|---|
index.mapping.total_fields.limit |
索引中允许的最大字段数量,包括字段映射、对象映射和字段别名。运行时映射字段也计入此限制。默认值为1000。此限制旨在防止映射和搜索过大导致性能下降和内存问题。如果提高此值,建议也提高indices.query.bool.max_clause_count设置(限制查询子句数量)。如果映射包含大量任意键,可考虑使用扁平化数据类型或将index.mapping.total_fields.ignore_dynamic_beyond_limit设为true。 |
index.mapping.total_fields.ignore_dynamic_beyond_limit |
确定当动态映射字段超过total_fields限制时的行为。默认为false,此时索引请求会失败;设为true则不会失败,超限字段不会添加到映射中,而是添加到_ignored字段。默认为false。 |
index.mapping.depth.limit |
字段的最大深度,即内部对象的最大嵌套层级数。默认为20。 |
index.mapping.nested_fields.limit |
索引中允许的最大nested类型映射数量。nested类型应该只在需要独立查询对象数组时使用,此限制避免映射设计不当。默认为50。 |
index.mapping.nested_objects.limit |
单个文档中所有nested类型允许包含的最大嵌套JSON对象数,有助于防止内存不足错误。默认为10000。 |
index.mapping.field_name_length.limit |
字段名称的最大长度限制,通常无需设置。默认为无限制(Long.MAX_VALUE)。 |
index.mapping.dimension_fields.limit |
索引允许的最大时间序列维度数量。默认为21。 |
这里说一下:index.mapping.total_fields.limit这个限制,在我们的测试环境使用ES的时候就触发过index映射字段超过限制的情况,如下是我们一开始一个业务插入的doc的简要结构:
jsonPOST codev_conscribe_team_devtest3/_update/2308971339019452418111
{
"upsert": {
"sub_mode": 101002,
"leader": 510000889,
"mode": 102,
"members": {
"510000889": {
"Avatar": "5400001",
"Uid": 510000889,
"Sex": 2,
"CurrentSegment": 1,
"Name": "最长一天开始了",
"AvatarFrame": 5000001
}
},
"max_segment": 8,
"mic_option": 1,
"view_count": 0,
"team_id": 2308971339019452400,
"publish_time": 1671848737,
"min_segment": 1,
"label_list": [
1,
3,
4
]
}
}
在程序运行了一段时间后,会发现当进行新的document发布的时候,会报错,如下:
bashcommon_decode_json_callback es error src publish_team_conscribe url codevidces.sz.es.svr.ehk.db.:31873/codev_conscribe_team_devtest3/_update/2308971339019452418 reason Limit of total fields [1000] has been exceeded
上面我们的members的value采用了JSON对象的结构,而不是数组,key的值是510000889 这些变化的uid,这就导致字段名就是这些变化的数字,最终导致在创建Index的时候,会为每个不同的uid都建立Index字段映射,我们看一下我们这个索引的mapping如下:
jsonGET codev_conscribe_team_devtest3/_mapping
{
"codev_conscribe_team_devtest3": {
"mappings": {
"properties": {
"label_list": { "type": "integer" },
"leader": { "type": "long", "index": false },
"max_segment": { "type": "short" },
"members": {
"properties": {
"510001090": {
"properties": {
"Avatar": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 }}},
"AvatarFrame": { "type": "long" },
"CurrentSegment": { "type": "long" },
"Name": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 }}},
"Sex": { "type": "long" },
"Uid": { "type": "long" }
}
},
"Avatar": { "type": "text", "index": false },
"AvatarFrame": { "type": "long", "index": false },
"CurrentSegment": { "type": "short", "index": false },
"Name": { "type": "text", "index": false },
"Sex": { "type": "short", "index": false },
"Uid": { "type": "long", "index": false }
}
},
"mic_option": { "type": "short" },
"min_segment": { "type": "short" },
"mode": { "type": "integer" },
"publish_time": { "type": "long" },
"sub_mode": { "type": "integer" },
"team_id": { "type": "long" },
"view_count": { "type": "integer" }
}
}
}
}
原因就是是为了防止Index过大,导致mapping爆炸,内存耗尽,搜索变缓等后果,ES默认对映射的字段大小进行了限制index.mapping.total_fields.limit,在这里修改index.mapping.total_fields.limit是没有意义的,因为正式环境uid会很多,所以最终修改members的写入,采用数组,而不是对象,所以后面进行了如下优化:
jsonPOST codev_conscribe_team_devtest3/_update/2308971339019452418111
{
"upsert": {
...
"members": [
{
"Avatar": "5400001",
"Uid": 510000889,
"Sex": 2,
"CurrentSegment": 1,
"Name": "最长一天开始了",
"AvatarFrame": 5000001
}
],
}
...
}
Index templates
在创建文档之前,可以通过创建索引模板来告诉Elasticsearch在创建文档索引时如何配置索引。无论是手动创建索引还是通过索引文档自动创建,模板设置都会被用作创建索引的基础。
下面介绍的Templates是「7.8」引入了新的索引模板设计,「7.8」引入了有两种类型的Templates:
- Component Templates(组件模板):用于配置mappings,settings,aliases。它是一个可被复用的构建块,可以被Index Templates包含;它并不能被直接用于索引构建;
- Index Templates(索引模块):可以是Component Templates的集合,也可以直接配置mappings,settings,aliases;它直接用于索引的构建;
「7.8」以前的
/_template/<index-template>格式的旧版的索引模板API被标记为deprecated,不再建议使用。
Index Templates(索引模块)需要注意一下几点:
- Index模板优先级高于「7.8」以前的旧式模板
_template,在建立索引时,如果没有匹配到合适的Index Template才会去匹配旧式模板; - 如果用显式设置创建索引,并且该索引也匹配一个索引模板,则创建索引请求中的设置优先于索引模板及其组件模板中指定的设置。
- 在索引模板自身中指定的设置优先于其组件模板中的设置。
- 如果新的数据流或索引匹配多个索引模板,则使用优先级最高的索引模板。
bashcurl -u 'walkerdu:123456' -X PUT "localhost:9200/_component_template/component_template1?pretty" -H 'Content-Type: application/json' -d '
{
"template": {
"mappings": {
"properties": {
"@timestamp": {
"type": "date"
}
}
}
}
}
'
Component Templates
组件模版Component Templates用于创建可用于复用的模版,格式如下:
jsonPUT /_component_template/<component-template-name>
请求参数
组件模版请求支持两个请求参数,用于控制组件模板创建请求的行为,:
create:可选值,默认false,表示是否为创建请求,如果是true表示:请求不能替换或更新现有的组件模板master_timeout:可选值,指定设置连接主节点的最长等待时间,以避免无限期等待,默认30s
如下简单测试:
jsonPUT /_component_template/tempate_1?create=true
{
"template": {
"settings": {
"number_of_shards": 1
}
}
}
请求体
组件模版创建的请求体主要分为以下几个一级属性:
| 属性 | 描述 |
|---|---|
template |
要应用的模板,可以选择包含mappings、settings或aliases配置。 |
version |
用于外部管理组件模板的版本号。这个数字不会被Elasticsearch自动生成或递增。 |
allow_auto_create |
覆盖action.auto_create_index集群设置的值。如果在模板中设置为true,则即使通过actions.auto_create_index禁用了自动创建索引,也可以使用该模板自动创建索引。如果设置为false,则必须显式创建与模板匹配的索引或数据流,永远不会自动创建。 |
_meta |
关于组件模板的可选用户元数据。可以包含任何内容,这个映射不会被Elasticsearch自动生成。 |
deprecated |
将此组件模板标记为已废弃。当在创建或更新非已废弃索引模板时引用了已废弃的组件模板,Elasticsearch将发出弃用警告。 |
创建请求体的一级字段template对象又包含以下二级属性字段:
| 属性 | 描述 |
|---|---|
aliases |
(可选,对象的对象)要添加的别名。如果索引模板包含data_stream对象,这些就是数据流别名。否则,这些就是索引别名。数据流别名忽略index_routing、routing和search_routing选项。 |
mappings |
(可选,映射对象)索引中字段的映射。如果指定,此映射可以包括:字段名、字段数据类型、映射参数。详见Mapping。 |
settings |
(可选,索引设置对象)索引的配置选项。详见 Index Settings.。 |
如下创建一个组件模版的示例,包含了索引设置,映射设置。
jsonPUT _component_template/template_1
{
"template": {
"settings": {
"number_of_shards": 1
},
"mappings": {
"_source": {
"enabled": false
},
"properties": {
"host_name": {
"type": "keyword"
},
"created_at": {
"type": "date",
"format": "EEE MMM dd HH:mm:ss Z yyyy"
}
}
}
}
}
Index Templates
Index Template直接用于索引的构建,它可以是Component Templates的集合,也可以直接配置mappings,settings,aliases。在「7.8」以前是通过旧式模板_template来进行索引模块的定义。
先看一下简单的示例,匹配"te"开头的索引和数据流,并为其设置索引参数"number_of_shards" : 2:
jsonPUT /_index_template/template_1
{
"index_patterns" : ["te*"],
"priority" : 1,
"template": {
"settings" : {
"number_of_shards" : 2
}
}
}
Elasticsearch通过通配符匹配新创建索引的名字,来将模块应用于新的索引。索引模板只在创建数据流或索引期间应用。对索引模板的更改不会影响现有索引。
下面介绍一下Index template的请求格式为:
jsonPUT /_index_template/<index-template>
请求参数
索引模版和组件模版一样,请求URI支持两个请求参数,用于控制索引模板创建请求的行为,:
create:可选值,默认false,表示是否为创建请求,如果是true表示:请求不能替换或更新现有的索引模板master_timeout:可选值,指定设置连接主节点的最长等待时间,以避免无限期等待,默认30s
请求体
下面是Index Template创建的请求体的一级属性字段:
| 属性 | 类型 | 描述 | 必需 | 示例 |
|---|---|---|---|---|
composed_of |
数组 | 一个有序列表,包含了要合并的组件模板的名称。 | 可选 | ["模板1", "模板2"] |
data_stream |
对象 | 如果包含此对象,则模板将用于创建数据流及其支持的索引。 | 可选 | {} |
index_patterns |
数组 | 用于在创建时匹配数据流和索引名称的通配符 (*) 表达式数组。 | 必需 | ["logs-*", "metrics-*"] |
_meta |
对象 | 包含关于索引模板的可选用户元数据,可用于提供额外的描述或信息。 | 可选 | {"description": "我的模板元数据"} |
priority |
整数 | 用于确定索引模板优先级的数字。较高的优先级意味着在创建新的数据流或索引时会优先选择此模板。 | 可选 | 10 |
template |
对象 | 要应用的模板,可以包括别名、映射或设置配置。 | 可选 | { "mappings": { ... }, "settings": { ... } } |
version |
整数 | 用于外部管理索引模板的版本号。 | 可选 | 2 |
deprecated |
布尔值 | 将此索引模板标记为已弃用。当创建或更新一个不再使用过时组件的非弃用索引模板时,Elasticsearch 将发出弃用警告。 | 可选 | true |
这里很多属性字段和上一节Component Template的作用是一致的,例如template字段包含mappings、settings或aliases配置,其包含的二级属性字段也是一致的。
这里比较特殊的就是:
index_patterns:通配符匹配新创建索引的名字,来将模块应用于新的索引;composed_of:索引模版要复用的组件模版的名称;多个组件模块会按照顺序进行合并,相同的定义,最后的组件模块内的优先级最高;
如下一个简单的示例:
jsonPUT /_component_template/template_with_2_shards
{
"template": {
"settings": {
"index.number_of_shards": 2
}
}
}
PUT /_component_template/template_with_3_shards
{
"template": {
"settings": {
"index.number_of_shards": 3
}
}
}
PUT /_index_template/template_1
{
"index_patterns": ["t*"],
"composed_of": ["template_with_2_shards", "template_with_3_shards"]
}
最后索引模版template_1的索引设置"index.number_of_shards"为3,因为"template_with_3_shards"更靠后,如果做一下修改:
jsonPUT /_index_template/template_1
{
"index_patterns": ["t*"],
"composed_of": ["template_with_2_shards", "template_with_3_shards"],
"template": {
"settings" : {
"number_of_shards" : 4
}
}
}
那么最后索引模版template_1的索引设置"index.number_of_shards"为4,因为Index template本身的索引设置优先级最高。
Legacy index templates
「7.8」以前是通过legacy template来进行索引模块的定义。现在已经被官方标记为deprecated,不再建议使用。这里也介绍一下legacy template,因为我们项目用的还是7.6的ES。
旧索引模版的请求URI格式如下:
jsonPUT /_template/<index-template-name>
请求参数
请求参数和「7.8」以后因为的Index template类似,不过多了一个order参数:
create:可选值,默认false,表示是否为创建请求,如果是true表示:请求不能替换或更新现有的索引模板master_timeout:可选值,指定设置连接主节点的最长等待时间,以避免无限期等待,默认30sorder:可选值,定义索引模版的优先级,用于一个索引在匹配到多个索引模版时,如何合并索引模版,多个匹配的索引模版会进行合并,针对相同的字段,order值大的会覆盖小的。
请求体
旧版本的索引模版的创建请求体相对来说比较简单,一级属性的结构如下,相对于「7.8」以后因为的Index template简单的多,新的索引模版创建了template一级属性,包含mappings、settings或aliases二级属性。
| 属性 | 描述 |
|---|---|
aliases |
(可选,对象的对象)要添加的别名。如果索引模板包含data_stream对象,这些就是数据流别名 |
mappings |
(可选,映射对象)索引中字段的映射。如果指定,此映射可以包括:字段名、字段数据类型、映射参数。详见Mapping。 |
settings |
(可选,索引设置对象)索引的配置选项。详见 Index Settings.。 |
index_patterns |
(必须,数组 ) 用于在创建时匹配数据流和索引名称的通配符 (*) 表达式数组。 |
version |
(可选,整数) 用于外部管理索引模板的版本号。| |
我们可以通过Kibana来管理所有以上介绍的索引模版和组件模版。
评论