一人之下手游是一款ARPG类型的游戏,核心是横板格斗,异人角色数值养成。在今年5-27号上线至今,服务器表现还算比较稳定,本文简要阐述一下一人手游的服务器架构设计,和大家一起探讨,相互学习~
1. 架构设计
游戏架构采用分区分服的设计,最开始设计的时候分为WX_IOS, WX_AND, QQ_IOS, QQ_AND四个大区,分安卓和IOS平台主要是苹果爸爸的规定,分QQ和WX平台是因为公司的两个平台爸爸的规定。所以分为四个大区是各个平台的规定,和游戏侧没有关系,从运营的角度来说也没有任何好处。后来根据运营需求,改造成了只有两个大区:QQ和WX,同一个账号的安卓和IOS平台都可以登录同一个区,但是数据是隔离的。去年公司开始推动QQ和WX平台游戏区打通,后面设计的游戏应该只会存在一个大区了,这对游戏开发和运营来说都是一个好事~
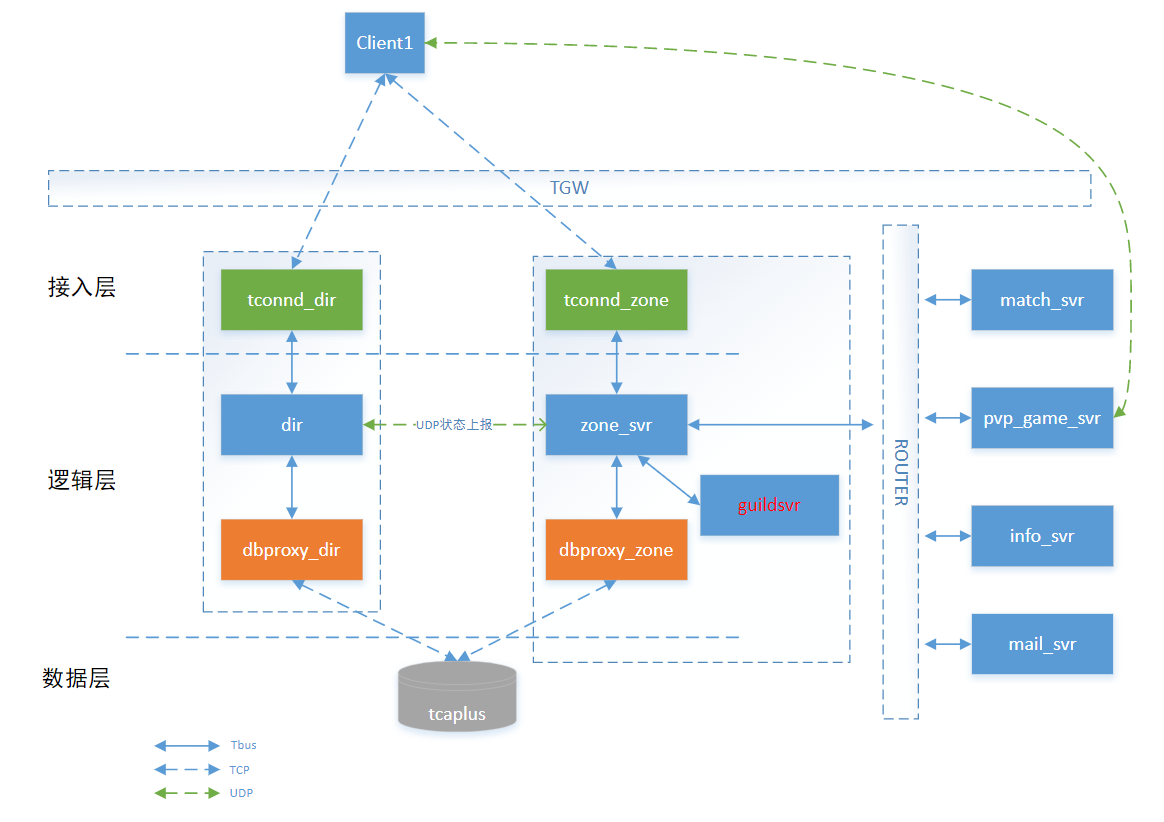
游戏核心架构如下:接入层采用tconnd组件,数据层nosql存储采用tcaplus服务,游戏内部各个模块之间通信采用tbus通信组件。其中dir负责游戏区的状态管理和玩家登录区的选择,zonesvr核心的游戏服务器,承载着玩家的登陆,在线,玩家数据的cache以及常规的游戏交互逻辑,
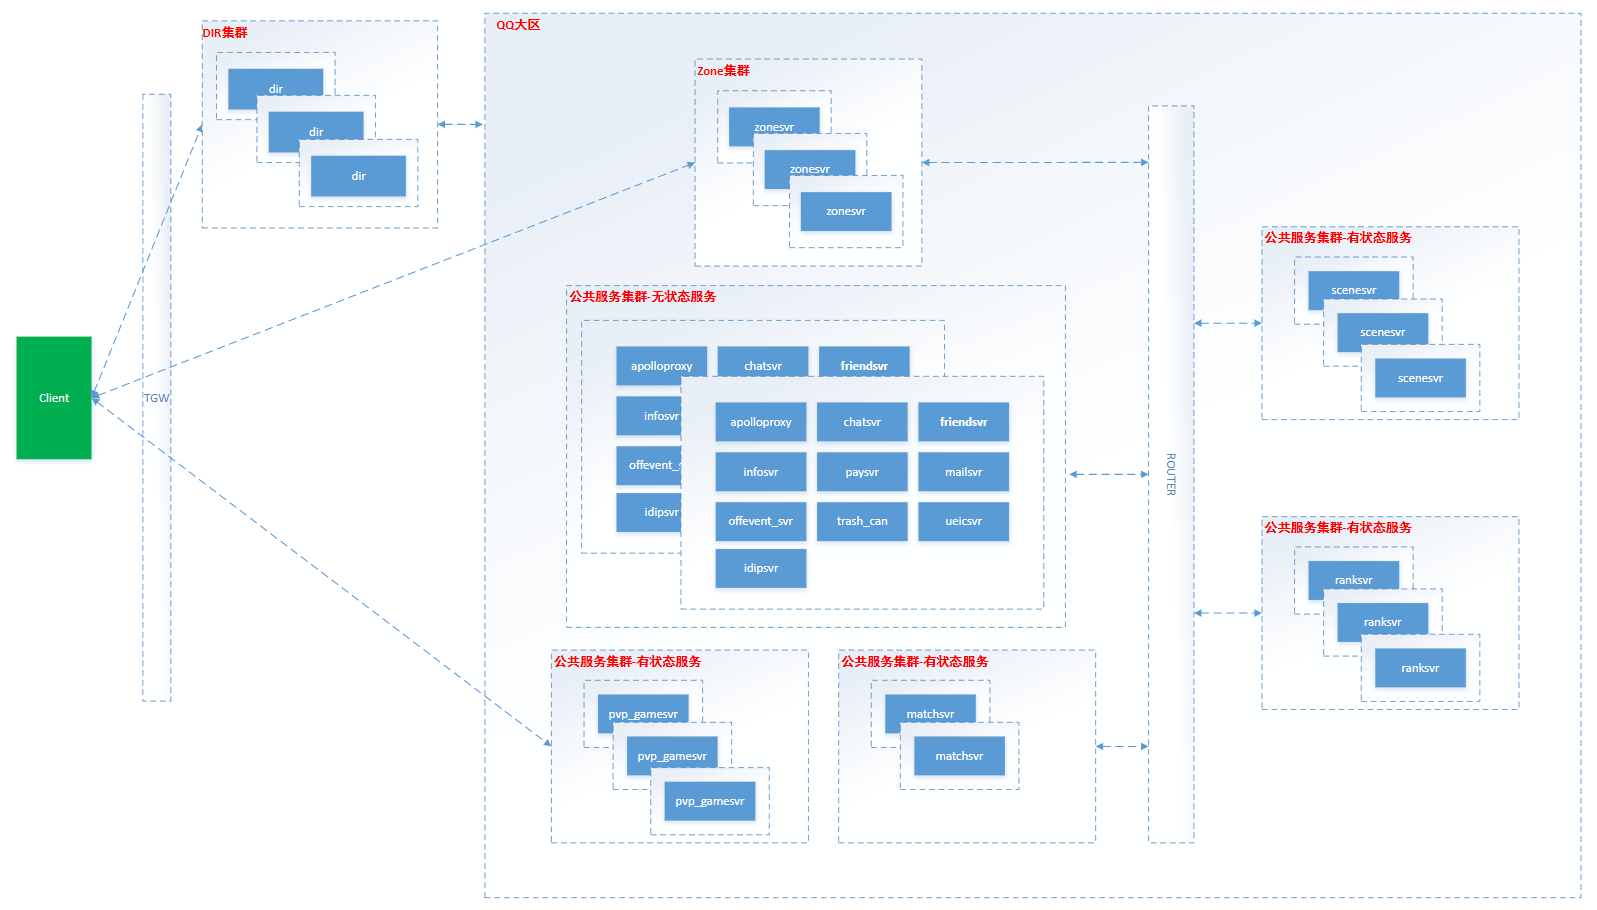
整个外网集群分为DIR集群,QQ大区,WX大区。其中DIR负责游戏区的状态管理和玩家登录区的选择,全服共享且无状态。QQ/WX大区包含Zonesvr集群,无状态的公共服务集群,有状态的公共服务集群,为了收敛tbus通道数量,它们之间的服务都通过router进行转发,形成了一个星状的网络拓扑结构。
账号体系
一人手游单个账号可以在一个区创建多个角色,游戏玩家的数据分为两部分:账号数据和角色数据,账号数据是一个账号在一个区下所有角色共享的。账号数据是通过openid + zoneid + platid进行隔离区分。角色数据通过gid来区分,gid的采用zoneid + platid + 自增ID进行编码,保证全局唯一。这里的platid表示安卓和IOS平台,不同平台的数据是隔离的。后续如果QQ和WX大区合并的话,platid就可以用来区分4个平台。
Dir
Dir作为目录服务器用来负责所有大区服务器的状态管理和玩家登录区的推荐,注册区的管理。所有zonesvr会定时向所有的Dir上报自己的状态以及在线,这样Dir就拥有所有zonesvr的状态和在线数据,Dir被设计成了全服无状态,可以平行扩容,TGW会根据负载均衡将请求转发到各个Dir服务器。
Zonesvr
zonesvr核心的游戏服务器,承载着玩家的登陆,在线,玩家数据的cache以及常规的游戏交互逻辑。目前一人之下采用的架构是单台物理zonesvr可以承载多个逻辑区,单个物理zonesvr上的多个逻辑区的玩法(除了跨服玩法)是隔离的。具体的物理zone到逻辑zone的对应关系由配置决定。zonesvr会定时向dir上报自己所有逻辑区的在线和注册情况。dir会根据所有zonesvr的承载情况进行新玩家的推荐。
Zonesvr即所谓的物理服,一个物理服可以支持多个逻辑服,但同一个逻辑服不能跨多个物理服。上线前期的部署规则是一个zonesvr只配置支持一个逻辑区玩家的登录,不同区的玩家不会登录到一台物理zone上。玩家登录上zonesvr后,玩家数据会cache在本地共享内存上,断线重连或下线5次心跳内重新登录都会之间复用本地cache的数据,不用去DB拉取数据。
由于后期加入了玩家场景交互的功能,最开始为了设计简单的原因,将场景同步的逻辑设计在了zonesvr上。
Dbproxy
作为proxy负责和tcaplus进行通信,解耦业务系统和tcaplus之间的交互。 其主要包含的业务逻辑就是负责玩家数据的注册和更新。dbproxy和zonesvr是直连部署在同台机器,减少请求的中转,以保证核心游戏服务访问tcaplus的稳定性。
Router
router作为服务之间的转发功能模块,负责了单个大区内的所有服务的路由管理。router维护了各个服务的路由表,并根据不同服务的转发规则(例如一致性HASH)建立对应的路由表。同时router的设计也是为了基于tbus通信的服务的通道数量的收敛,如果没有router中转单元,那么整个服务网络是一个网状结构,每个服务的通道数量会很多,而tbus在通道数量过多的情况下,处理性能会下降很多,且内存占用量也会很大。
matchsvr
matchsvr负责不同的PVE,PVP玩法战斗匹配,matchsvr目前支持单个玩家匹配后创建单局,多人组队的方式进入创建单局。matchsvr除了匹配的功能外,就是负责单局战斗的创建,包括PVP和PVE,matchsvr维护了所有pvpgamesvr的状态和负载情况,以选择合适的pvpgamesvr进行单局的管理。
目前针对有限有状态的matchsvr设计成单个大区一主一备,当主挂了之后,由备机提供服务。由于matchsvr上保存的是匹配数据,在服务挂了后,只影响当前玩家的匹配,表现就是匹配超时,切换到备机后,玩家只需要再次点击匹配就可以正常进行匹配操作。
pvp_gamesvr
游戏核心战斗服务器,负责单局的战斗,采用基于UDP的帧同步进行玩家战斗数据的同步。
有状态的pvpgamesvr同样只是保存了玩家当前单局战斗,采用和无状态服务一样容灾逻辑,挂了从集群中剔除。
scenesvr
场景服务是为了一些跨服玩法进行场景管理而设计的。现在scenesvr不仅包含了场景视野的管理,还耦合了一些玩法相关的逻辑,这部分其实是因为快速开发而带来的结果,其实设计上还是剥离出来比较好。
infosvr
作为游戏比较重要的一个公共的服务,提供游戏内玩家之间基本信息的查询,游戏内关于玩家简要信息的展示,例如排行榜,场景玩家信息查看等都会通过infosvr进行查询。设计上infosvr作为无状态的服务,大区公用。
因为infosvr会回写玩家简要数据,所以为了能让同一个角色的请求转发到同一个infosvr进行串行操作,需要通过角色id进行一致性HASH,除此之外还需要结合DB的data version来进行最终的数据修改操作以防止infosvr服务节点发生变更时,hash转发规则会发生变化,导致最终的并发修改。
paysvr
负责游戏的支付逻辑,和midas进行交互,包括游戏支付后的点券同步逻辑和直购发货逻辑。paysvr的独立设计同样解耦了游戏侧和midas平台侧的交互,在设计上paysvr作为无状态的服务,大区公用,可以进行平行扩容,当然如果paysvr出现性能瓶颈,应该是很值得开心的一件事情。
idipsvr
作为游戏必不可少的一个服务,主要提供周边系统的支持服务,例如客服服务,大管家,业务合作等游戏侧的功能接口支持。由于腾讯游戏服务要求的提升,gidip近年来提供的功能越来越多,例如成长守护平台,账号注销等公司比较重视的功能。设计上idipsvr也是大区无状态的。
由于idipsvr需要修改玩家数据:通过离线事件或者邮件,所以会有防并发逻辑,如果平台侧连续发送多条修改操作,可能会触发防并发逻辑,导致部分修改操作失败。
mailsvr
mailsvr作为邮件服务器负责玩家邮件的交互逻辑,包括发送邮件、获取邮件列表、领取邮件附件等功能。对于邮件服的请求同样也会根据角色id进行一致性HASH,除此之外还需要结合DB的data version来进行最终的数据修改操作以防止mailsvr服务节点发生变更时,hash转发规则会发生变化,导致最终的并发修改。
friendsvr
好友服务器负责玩家的好友的交互逻辑,包括加好友,获取好友列表等功能。
apolloproxy
apolloproxy服务负责代理和apollo平台服务之间的通信,apollo服务主要提供了平台侧(QQ/WX)个人账号信息查询,关系链拉取,排行榜服务等。proxy解耦了游戏侧和平台侧的交互,同时,可以进行平衡扩容。
2. 架构要点
玩家数据
游戏中玩家的数据由tcaplus公共服务进行cache,并负责容灾和落地。tcaplus中的blob数据为了方便的扩展和动态更新,采用protobuf结构进行存储和解析。
由于玩家的核心数据相对比较大,如果每次操作都从tcaplus进行拉取,反序列化,修改,序列化,回写,会有很大的性能开销和网络延迟,无法支撑大量玩家的并发操作。所以zonesvr上,会将登录的玩家数据在共享内存上进行cache,常用的cache方案有两种:
- cache的数据是序列化后的数据,每次操作会首先将本地的数据进行反序列化,然后进行修改,再序列化到本地。定时的针对玩家脏数据进行回写操作,保障数据落地到tcaplus。这样做的好处是:不用每次都远程操作tcaplus,只需操作本地cache的blob数据,且版本更新对于数据修改可以支持热更,不需要进行停服。缺点是即使每次操作只需要解析本地的blob数据,在玩家数据膨胀后,也会造成反序列化的性能开销变大,常用的优化方法是让protobuf支持懒解析的功能。
- cache的数据是POD的数据,每次操作直接对玩家数据进行修改,不需要进行反序列化和序列化操作。没有任何性能开销。定时的针对玩家数据进行序列化回写操作,让数据落到tcaplus。这样做的好处是:玩家数据的修改没有任何成本。但是如果玩家数据的结构发生修改就必须进行停服更新。
一人之下手游采用的是第二种方案:玩家Cache在共享内存上的数据是POD数据。POD的数据的结构是根据protobuf的proto IDL生成的,生成方式其实就是将message映射成struct,repeated结构生成一个IDL描述的固定长度的数组,保证protobuf的message能够变成一个共享内存上的POD结构。
对于玩家cache的POD数据,有一个很大的风险点是:代码逻辑可能导致玩家的数据被写坏。因为玩家数据都是cache在共享内存上,且相互临近,所以如果代码逻辑有问题,可能导致玩家数据被写坏,且有可能无法察觉导致问题扩散。即使后来我们在玩家数据前后加了4K的保护页,但是针对这种POD的数据还是无法做到很好的保护。
服务容灾
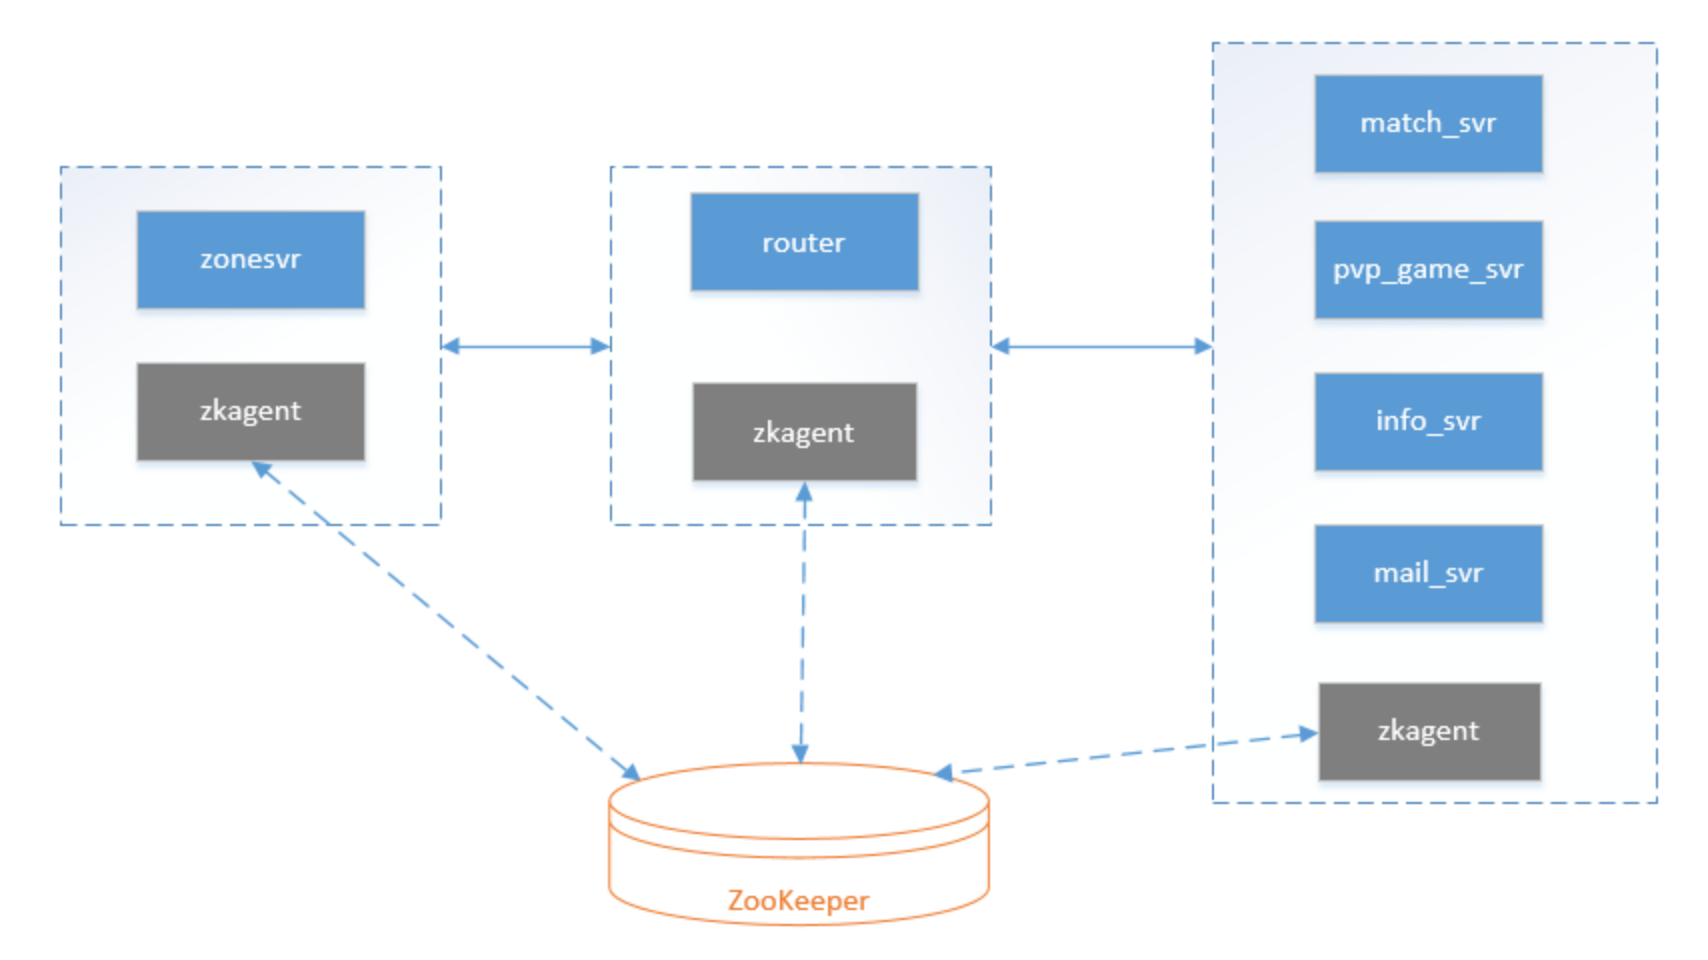
在架构中,除了核心游戏服务器外,很多公共无状态的服务考虑性能和单点问题,需要部署多台,这里需要对这些无状态的公共服务进行容灾处理,一人之下通过zookeeper进行容灾处理。
游戏中对zk的相关api调用封装在了zkagent中,需要容灾的服务会定时的通过zkagent上报自己的状态到zookeeper中,zkagent同样会定时的从zookeeper中拉取存活服务的最新状态列表,如果发现和本地的配置不一致则更新对应的配置并重启对应的服务。
例如,zonesvr需要对router进行容灾,所有router会定时通过zkagent向zookeeper上报自己的状态,zonesvr的zkagent会定时的拉取所有router的状态,如果发现router集群的数量有发生变更,就用最新的所有router地址覆盖zonesvr本地的router配置,然后从新load zonesvr的路由配置。
3. 架构问题
路由不一致问题
对于现有的架构,虽然通过zookeeper对无状态的服务进行了容灾,但是其实是有问题的,可能会存在路由不一致性的问题。例如zonesvr对router进行了容灾,当某台router挂掉之后,zookeeper更新了最新的router集群的状态。但是某个zonesvr可能此时到zookeeper的网络出现问题,无法拉取到router集群的最新状态,此时这个zonesvr和其他zonesvr所看到的router列表就是不一致的。
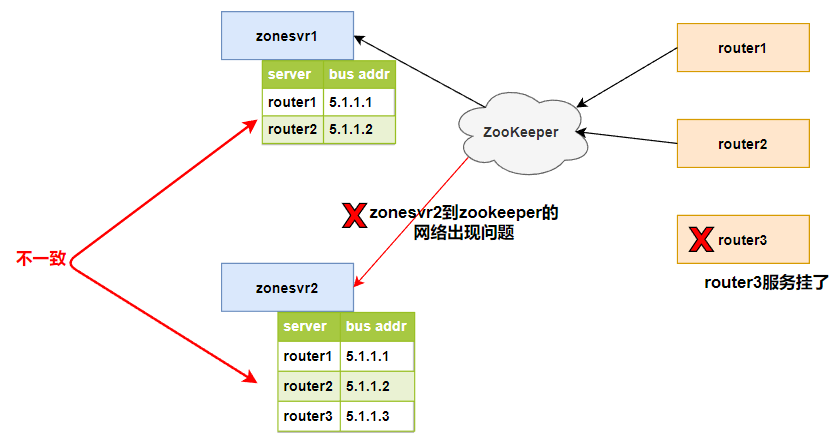
假如某台router到zookeeper的网络不通,会导致router的上报出现问题,zookeeper中该router会失效,但是router到其他服务的网络都是正常的,这时候正常的router就会被从集群中剔除,不提供服务。虽然这对于无状态的router影响不是很大,但是这个问题还是存在的。假如zookeeper集群的网络出现问题,导致小部分router上报有效,大部分router的上报丢失,整个服务集群中,router的状态就会有很大的不一致。
同样router对于公共服务的容灾,也会存在各个router可能对公共服务的路由发生不一致的问题。
上面描述的问题,发生的概率比较小,且发生了一般会段时间修复,如果出现了极限情况,长时间路由不一致,这个时候就需要手动进行干预处理。
有状态服务的恢复
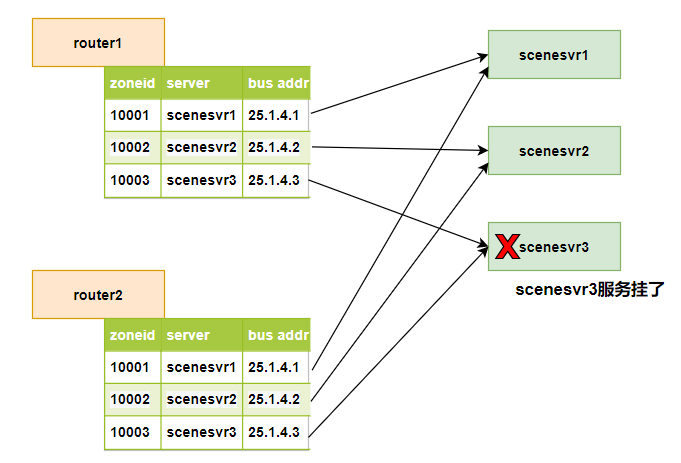
目前游戏内有状态的服务包括zonesvr,guildsvr,ranksvr,scenesvr等。有状态服务的特点是固定ID请求只能转发到对应的server,强绑定状态,且server上cache数据。
针对有限有状态的matchsvr,pvpgamesvr上面也介绍了,其故障后不需要进行恢复,matchsvr切换到备机,pvpgamesvr直接从集群中剔除。
scenesvr在不删档开服前一直设计上是按照zoneid一致性进行路由映射的。但是在搭建不删档环境的时候,发现一致性hash在zoneid只要100多的时候,会造成hash结果不均匀的情况,有些scenesvr节点根本没有被分配到请求。
因为请求的节点个数数据相对较少,所以无法保证hash结果的相对均匀,最终采用了简单的按zoneid一一转发的固定路由设计,保证scenesvr能够均匀的分散各个zonesvr的请求。针对这种情况scenesvr故障后就会影响到固定区的功能,就需要人工接入进行恢复。同样针对zonesvr,guildsvr,ranksvr也是会有这个问题,服务故障需要人工介入进行业务的恢复。
4. 未来优化思考
单服支撑上限
由于一人采用分区分服的架构设计,且一个游戏逻辑区只能在一个物理区上。所以导致了单服是有PCU和注册上限的限制。由于游戏中包含了主城的场景同步,目前单服PCU上限外网设置为1W。这就导致了不删档开服期间,开服的速度会非常的快,然后后面新开的服由于流失的原因很快就会变成鬼服,严重影响游戏的体验。
其实可以借鉴现在大部分单句游戏的架构设计,采用全区全服的思想来设计分区分服的游戏。游戏的一个逻辑区可以分布在多个物理区,一个物理区承载多个逻辑区,这样游戏逻辑区的PCU完全取决于配置和服务器的数量。
这样也会带来一些不方便地方就是: 作为RPG类型的游戏,很多单服的玩法也要通过跨服的方式进行实现,工作量上势必会增加很多。例如单服内的场景同步就需要采用跨服的设计方式将分布在不同物理服务器的玩家映射到一台单独的场景服务进行场景内的交互。
路由一致性和调度管理
前面也分析了现有游戏架构中路由不一致的问题,以及对于有状态服务的路由均匀问题。对于这两个问题都需要引入一个协调者进行路由的管理,这个也是接下来我打算做的事情之一。
对于路由一致性,协调者需要根据服务中心最新的服务状态,通过一致性算法(2PC, 3PC, TCC,raft, gossip等)进行各个router一致性路由的维护,以保证各个服务看到的路由信息是一致的,虽然可能不是最新。可用性对于业务来说还是很重要的。
对于路由的调度,现有的一致性算法在请求节点key少量的情况下其实很难做到路由均衡的效果,特别是游戏服务中按zoneid一致性hash,如果是对于有状态服务,采用此种路由,势必会导致不均衡的后果。如果希望动态的进行有状态服务的路由就需要引入一个调度管理的角色。
同样对于部分有状态服务的恢复也可以通过引入调度中心来进行及时的恢复,而不是现在借助与腾讯云的迁移技术进行业务的恢复。
评论