KO-PR2测试前压测cpu和内存泄漏问题分析
11月份进行pr2测试,此前虽然经过了tdr3的服务器性能测试要求,但是3test的0809版本出现过人多的时候CPU过高的问题,后来又新增了很多逻辑代码,所以此次PR2此时前需要进行压力测试,对于性能瓶颈的地方进行修正,为上线做准备。
压测数据准备
这是三测两个版本0713和0809两次的线网测试的协议占比,
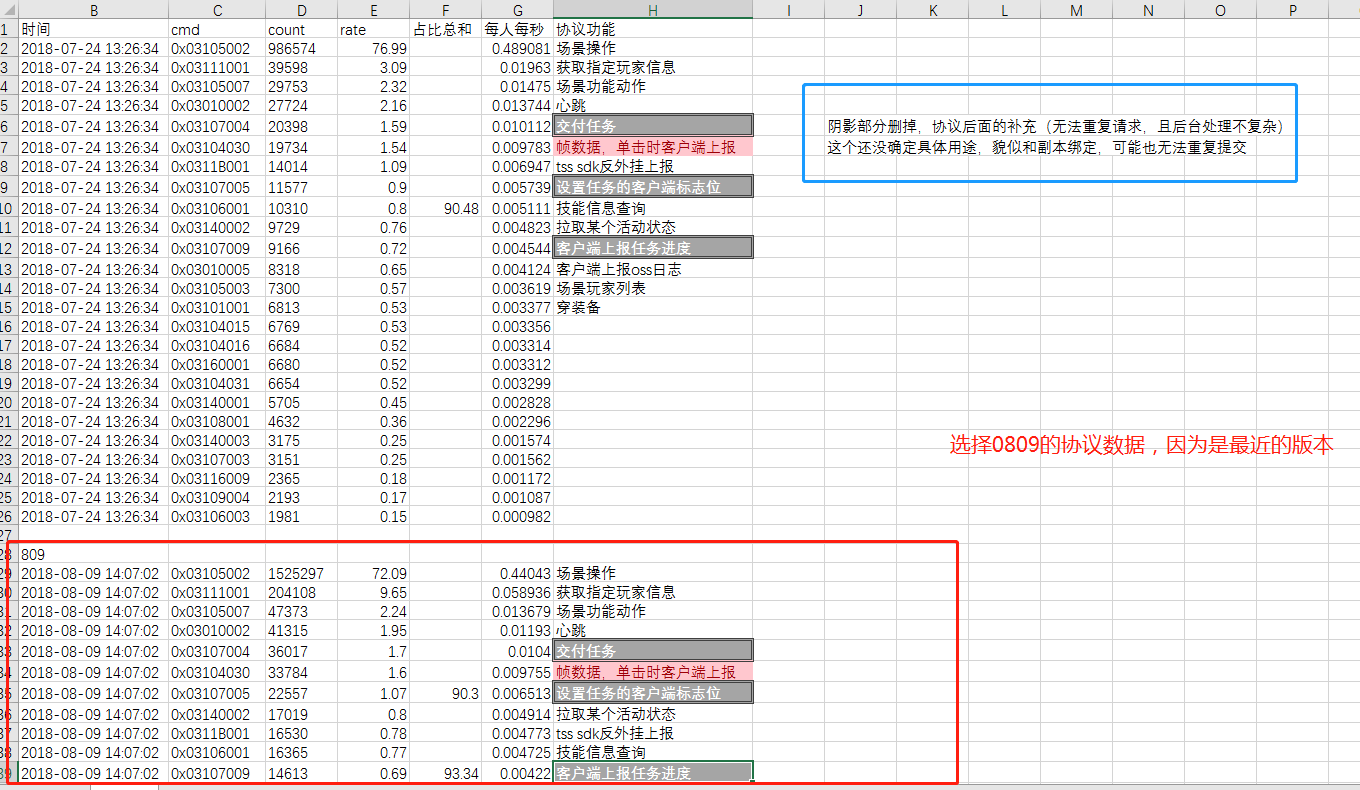
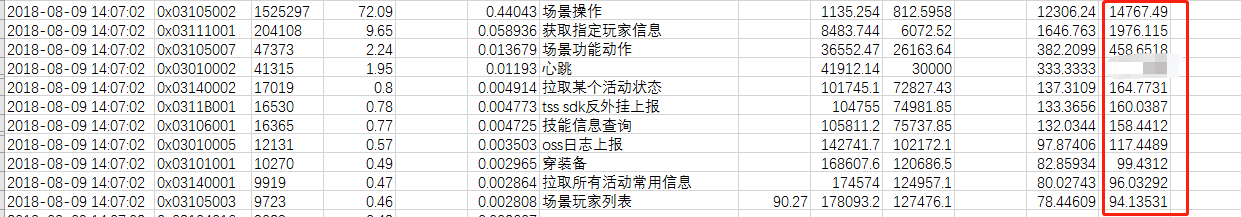
按照12000同时在线,按照外网的tps请求量的两倍进行压测,对应的cmd分布情况如下:
第一轮压测
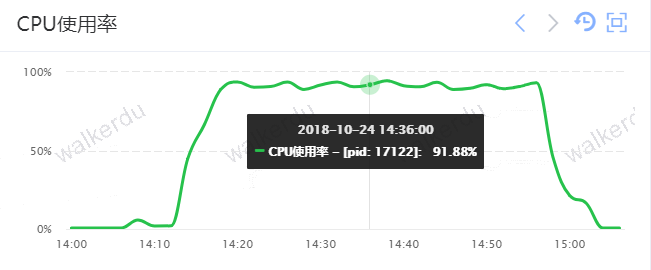
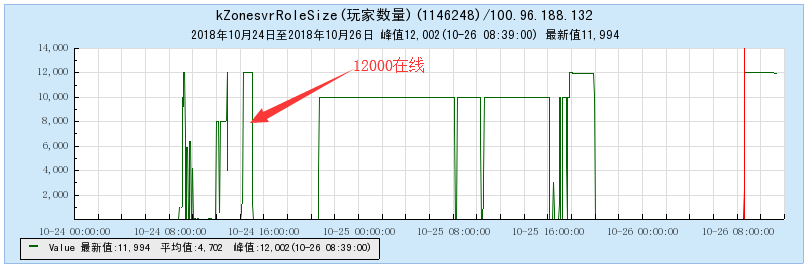
在12000同时在线的综合场景的压测的时候,CPU平均跑到了92%左右,CPU和玩家数量记录如下如下:
第一轮压测的CPU Profiling过程
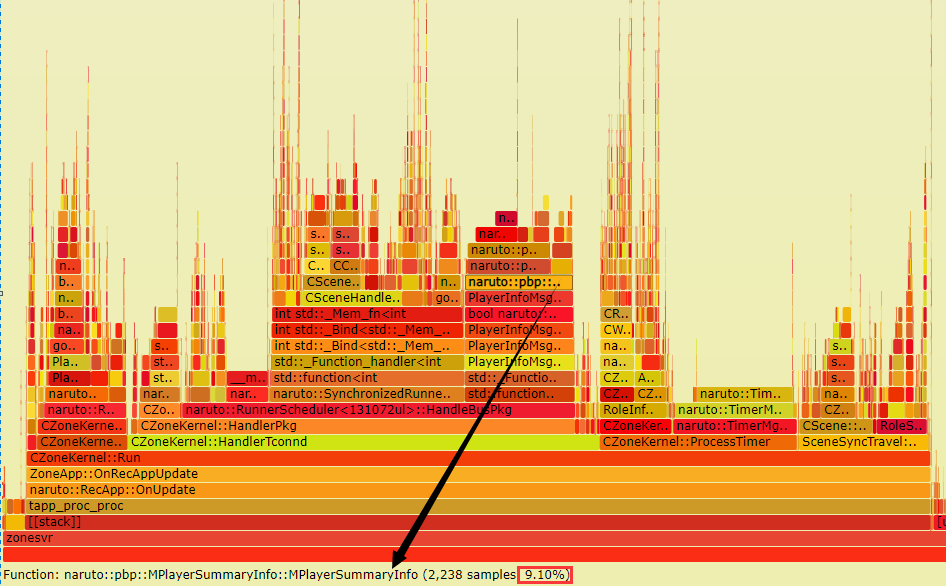
第一轮压测同时在线12000的情况下cpu基本跑满,下面是通过perf对zonesvr的profile的结果,我们可以看到性能最耗的部分在拉去玩家个人简要信息的地方,但这个请求并不是最多了,肯定是有问题的,我们看看消耗在哪个地方了。
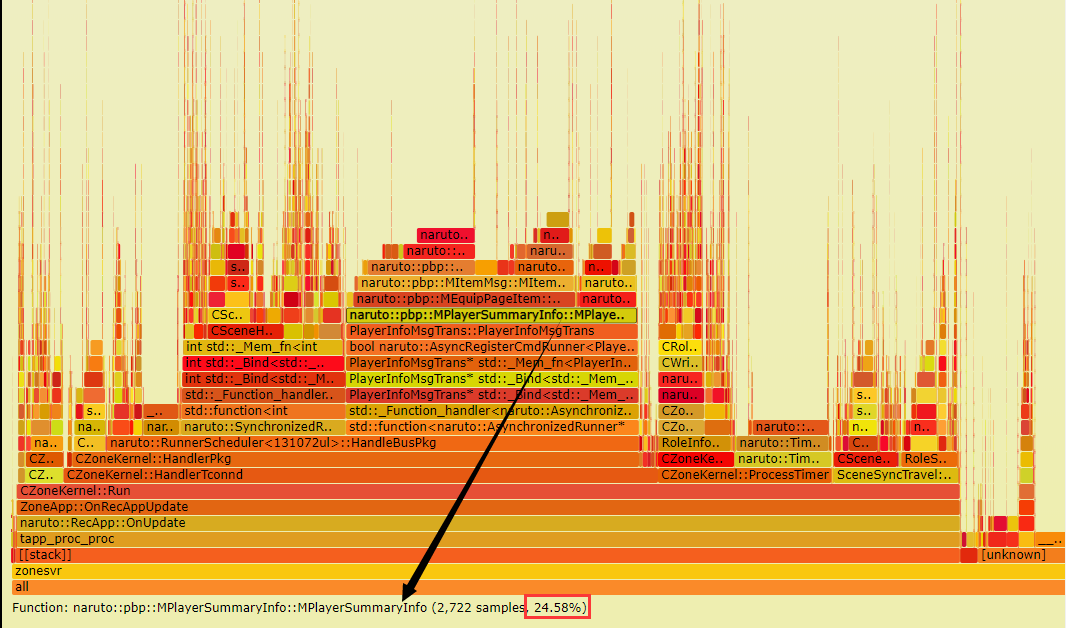
拉取简要信息的事务中,MPlayerSummaryInfo的构造函数占了整个cpu时间的24%, 为什么呢?
这个结构很复杂,但不应该在构造的时候花那么多时间了,构造的时候都干了什么了?这个结构是PBP工具根据protocol buffer的结构自动生成了,不看不知道,一看吓一跳:
c++/*用户玩家信息页面的玩家信息*/
struct MPlayerSummaryInfo
{
int32_t info_status;
MPlayerSummaryBasicInfo player_basic_info;
MEquipPageItem item_info;
MFullFightAttrs fight_attrs;
/*repeated ItemMsg medicine = 6; // 药品信息*/
MZoneGuildBriefInfo guild_info;
uint32_t avatars_num;
MUIntKV avatars[MAX_FASHION_CNT];
uint32_t use_magic_item_num;
MUseMagicItemSlotInfo use_magic_item[MAGIC_ITEM_USE_SLOT_CNT];
...
};
MPlayerSummaryInfo::MPlayerSummaryInfo()
{
Clean();
}
void MPlayerSummaryInfo::Clean()
{
info_status = 0;
bzero(&player_basic_info, sizeof(player_basic_info));
bzero(&item_info, sizeof(item_info));
bzero(&fight_attrs, sizeof(fight_attrs));
bzero(&guild_info, sizeof(guild_info));
avatars_num = 0;
bzero(avatars, sizeof(avatars));
use_magic_item_num = 0;
bzero(use_magic_item, sizeof(use_magic_item));
}
你会发现PBP生成的MPlayerSummaryInfo的构造函数会调用Clean()把所有的成员都置0,可怕的是MPlayerSummaryInfo的自定义数据成员也会调用自己的构造函数进行Clean(),因为它的自定义数据成员也是由PBP生成的,每个构造函数里面都会有Clean()操作,这是设计PBP工具的人没有意识到在C++中类的初始化过程,
C++中类在初始化的时候对于内置类型的数据成员是未定义的,对于自定义类型的数据成员会调用该类型的构造函数进行初始化
所以导致的结果是,这个性能开销是一个指数级的,任何一个内部结构被多余bzero的次数是它的深度,这是一个n叉树的结构,我们已完全2叉树来简单分析一下重复bzero的次数:
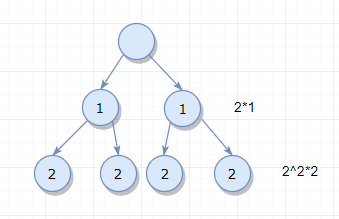 $$
重复bzero的次数T(h)=21+2^22+...2^{h-1}(h-1)=\sum_{x=1}^{h-1}2^xx
$$
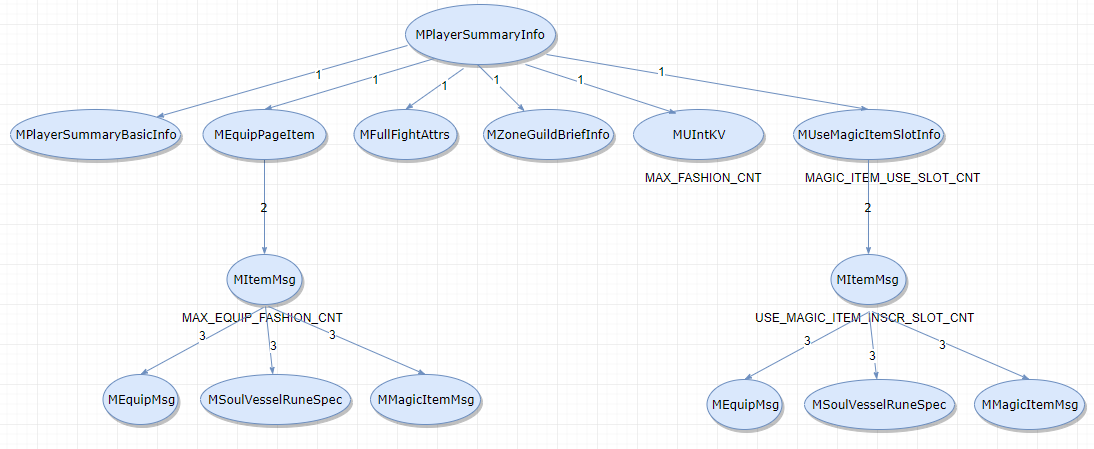
MPlayerSummaryInfo的结构复杂如下,我只画到第三层,下面标有数字的节点代表是一个数组,如果要扩展开来是很恐怖的
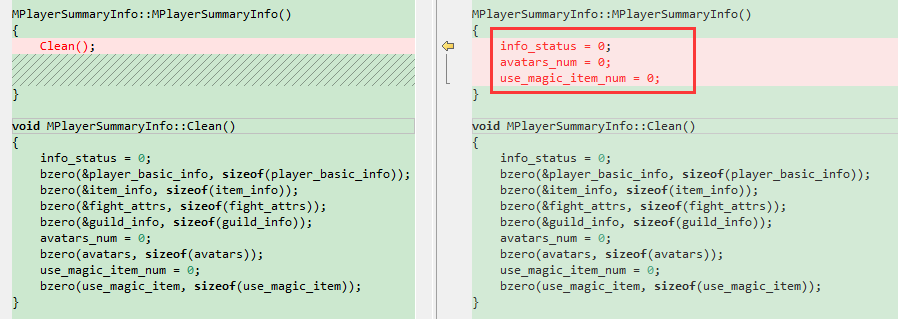
所以解决办法也是很简单就是PBP生成的结构中只对内置类型的数据成员进行初始化,自定义的成员会自动调用它自己的构造函数进行初始化,不用关心。
第二轮压测
对上述PBP对象构造进行优化后,再进行12000同时在线的综合场景的压测,如下:CPU使用率降到了80%以下:
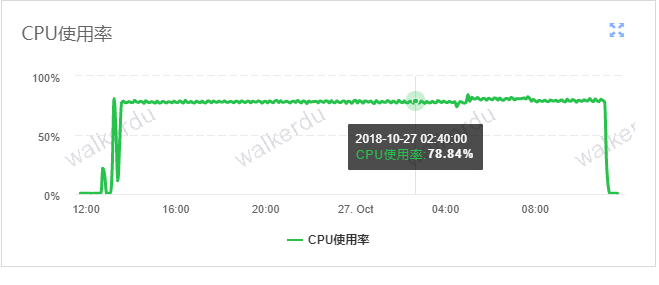
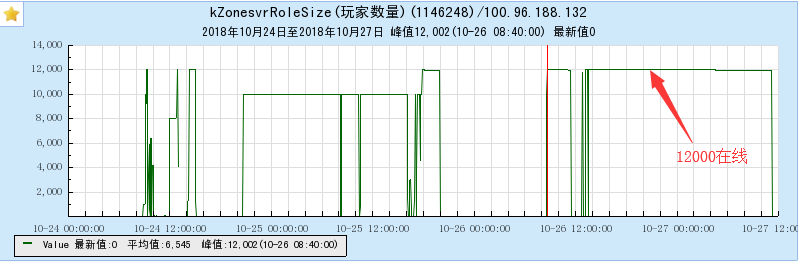
对优化过后的zonesvr进行perf的结果可以看到, MPlayerSummaryInfo的构造函数占用的cpu时间从24%降低到9%.还是很明显的。
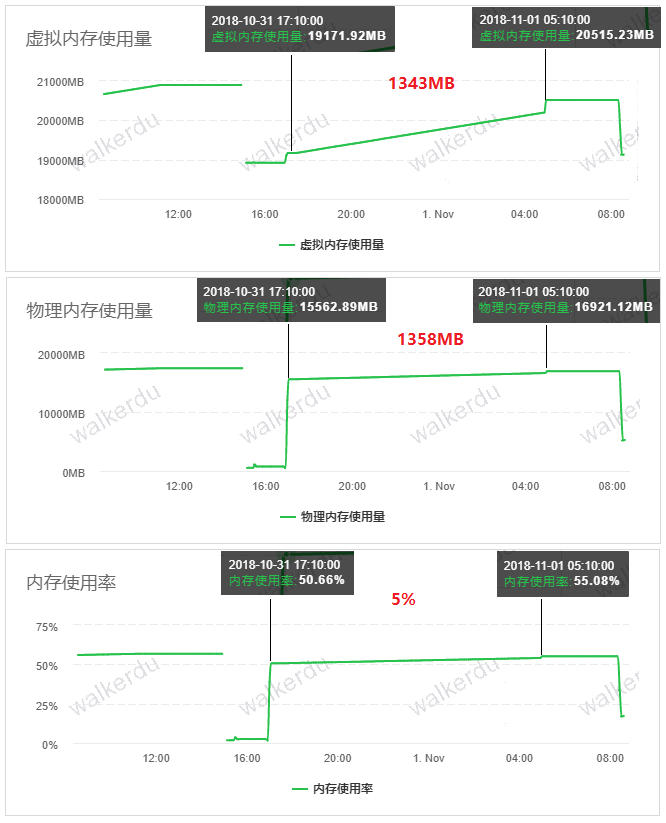
但是,喜极而泣,压了一段时间后,发现虚拟内存一直在增加,内存使用率也在慢慢上升,压测一段时间后,不应该有这种内存持续性的增加,感觉内存泄漏发生了。。。
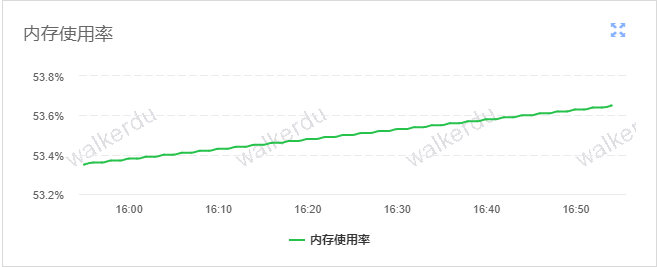
以1.5M/min的速度发生泄漏,90M/h, 2160M/Day...实际结果是压了12h,内存增长了1343.31MB。。。
第二轮压测Mem leak的Profiling过程
对于内存泄漏的检查算是耗时比较长的,前后有1周多的时间,其实通过最原始的方法,加监控和日志时可以分析出来的,但为了能够使用通用的分析方案,防止以后再次出现问题,还是没有快速高效的方式来定位,所以过程比较耗时。
valgrind memcheck
首先是想到用valgrind memcheck进行简单的内存泄漏检查:
valgrind --tool=memcheck --leak-check=yes --trace-children=yes ./zonesvr --noloadconf --log-file=../log --conf-file=../conf/zoneconf.xml --id=3.1.1.1 --bus-key=1688 --business-id=0 -D start
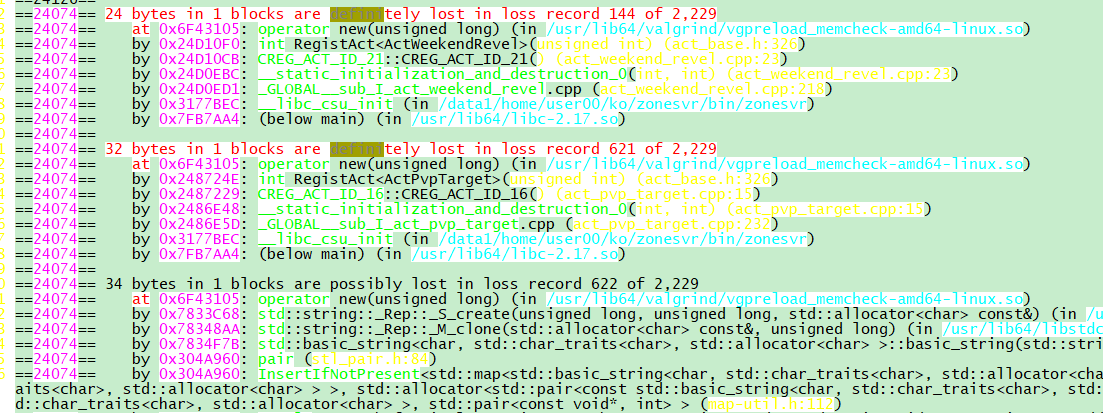
可以看到都是预先分配的,valgrind对于分析内存泄漏中:非法地址方法,无主内存泄漏定位很有帮助,但对于动态的堆内存泄漏很难检查,且会让程序慢(20 to 30 times) ,对于在压测时候都是缓慢的内存泄漏,使用valgrind很难分析问题点的。
gperftools heap profile
那就是使用gperftools的libtcmalloc了,虽然它也会是应用程序的新能降低5倍左右,gperftools提供了两种内存泄漏的分析方式:
-
heap-checker: 一般的使用方式是进程启动时进行内存alloc的追踪,进程退出时再次进行check。进程退出时,任何无主内存都会被记录下来,程序在exit()时,执行的清理操作包括销毁静态存储区的对象,所以对于最常见的容器的泄漏时无法定位的。
If it finds any memory leaks -- that is, any memory not pointed to by objects that are still "live" at program-exit -- it aborts the program (via
exit(1)) and prints a message describing how to track down the memory leak -
heap-profiler:可以分析出进程在任何一个时刻的heap使用情况,定位出内存泄漏。通过pprof工具可以直接将不同时间段的dump下来的进程heap使用情况进行对比,查看增长点,这个功能实在时很实用。
env LD_PRELOAD="./libtcmalloc.so" HEAP_PROFILE_TIME_INTERVAL=600 HEAP_PROFILE_ALLOCATION_INTERVAL=1073741824 HEAPPROFILE="./gperf.log" ./zonesvr --noloadconf --log-file=../log --conf-file=../conf/zoneconf.xml --id=3.1.1.1 --bus-key=1688 --business-id=0 -D restart
结果让我崩溃,我们的devnet的开发机的gperftools的heap profile 是有结果,且能够进行分析的,但是idc的docker中虽然生成了结果,但完全没有有用的信息,无法profiler结果,无奈之下,我想到的是能不能用perf proble对malloc的tracepoint进行分析。
perf probe malloc
通过在libc中添加malloc的tracepoint,来统计malloc的使用情况:
shell# perf probe -x /lib64/libc.so.6 malloc
# perf record -e probe_libc:malloc -g -p 18643
Error:
The sys_perf_event_open() syscall returned with 22 (Invalid argument) for event (probe_libc:malloc).
/bin/dmesg may provide additional information.
No CONFIG_PERF_EVENTS=y kernel support configured?
在我的devnet机器下也是可以的,为啥idc下面又不行了呢?
找到运维同学,请教为什么?在拉了计算资源组同学qiwu和tlinux helper后,得知:操作系统用的libc 和docker 容器中用的libc 不是同一个,在docker容器中执行perf probe -x /lib64/libc.so.6 malloc 对应的 入口函数地址是 docker 容器的 libc文件的malloc地址,而执行perf record的时候去找的是母机的libc的入口地址。
最终申请一台虚拟机,去跑malloc的分析结果,结果发现跑一段时间后,OOM了,malloc的事件触发太频繁了,在短时间的perf过程中,3min时间采样结果就达到了3G的数据,
shell[ perf record: Woken up 12336 times to write data ]
[ perf record: Captured and wrote 3084.475 MB perf.data (~134762759 samples) ]
对于这个3G的perf data进行分析过程消耗了3G的内存和4min的时间,分析结果如下:
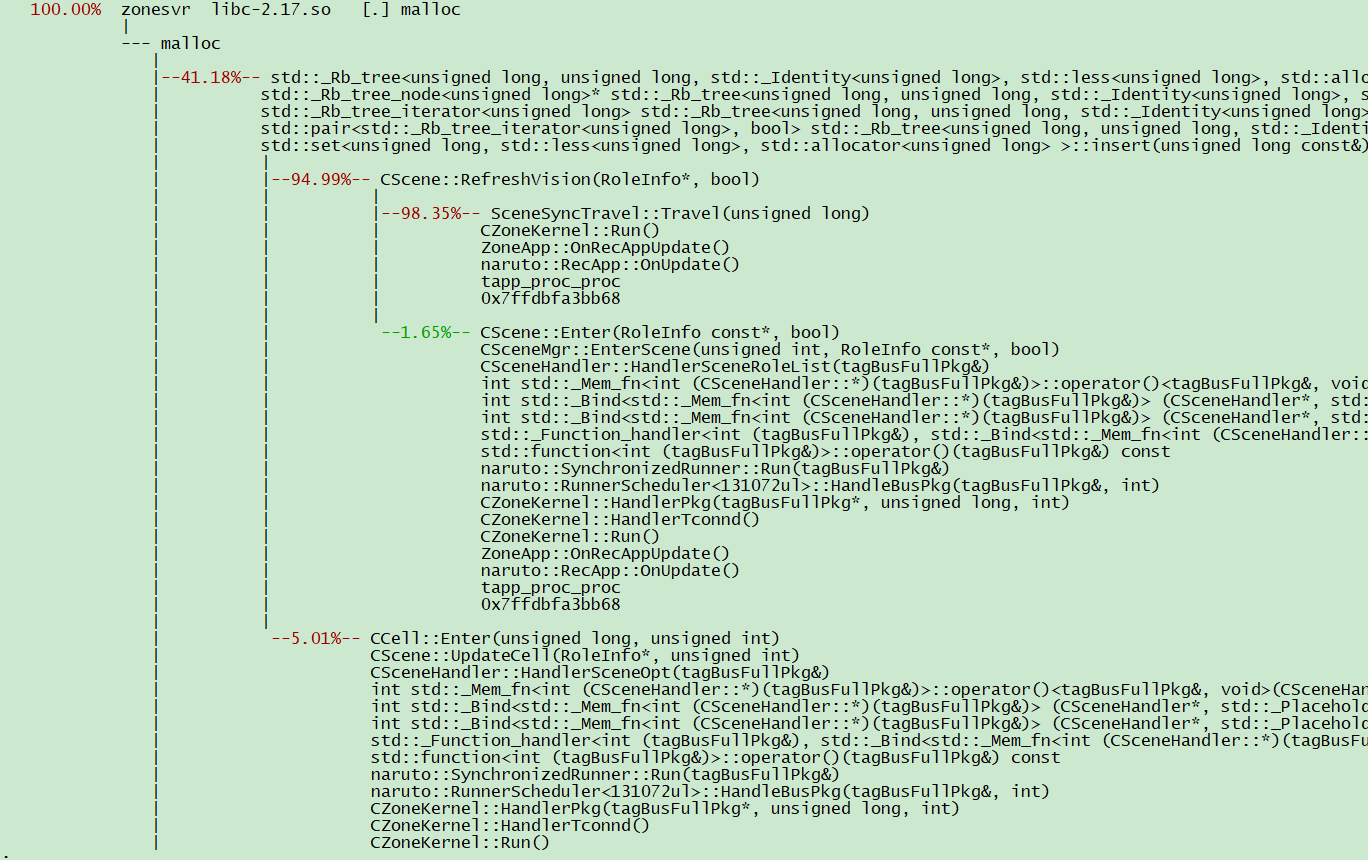
这里的结果很多,但是调用mallco最多的并不是说明内存泄漏的地方,由于只能跑3min看结果,所以这么多的输出,看起来是很费力的,很难去分析泄漏点。
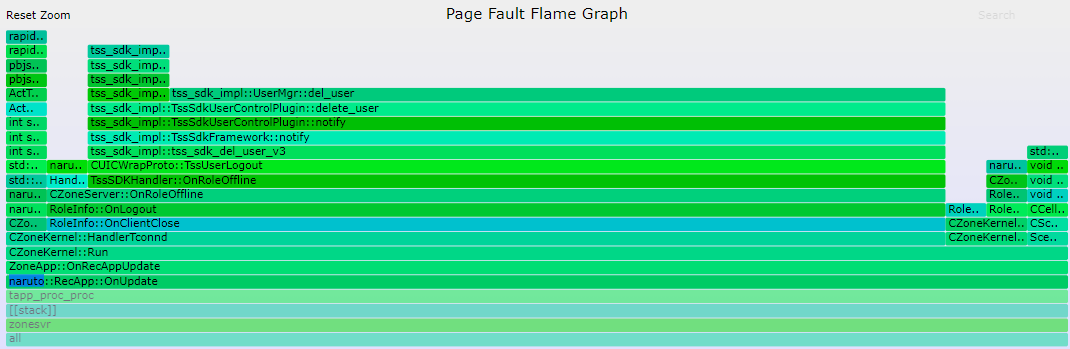
同样通过perf 进行page-faults events事件的分析,也是无法看出什么异常:
perf page-faults event
查看分配内存时页错误的统计http://www.brendangregg.com/FlameGraphs/memoryflamegraphs.html
textperf record -e page-faults -F 99 -g -p 162731 -o page-faults.perf -- sleep 14400
perf script -i ../page-faults.perf.valid1 |./stackcollapse-perf.pl|./flamegraph.pl --color=mem --title="Page Fault Flame Graph" --countname="pages" > page-faults.svg
gperftools heap profile
最终经过了一周的折腾,包括申请一台虚拟机,最终发现的现象是:当zonesvr的玩家节点达到一点数量后,gperftools的heap profile就要么生成的heap profile的结果为0,要么其结果无法解析。在我devnet的开发环境中,玩家的节点个数只有200个,在压测环境12000在线的情况下,32G内存只有5G可用,此时gperftools无法正常运行,改成6000后,gperftools的heap profile正常输出结果。
我们知道gperftools的heap profile在通过其本身提供的tcmalloc来实现内存分析的,profiling过程中,会对所有内存分配和释放进行监控,在每次进行内存分配的地方:malloc, calloc,realloc, new的地方进行栈跟踪。 这里会导致额外的内存开销,且会降低程序的性能。但是这里消耗那么多内存实在让人难以理解, 按照gperftools issues674说法,会是原来内存开销的数倍:
In both cases tcmalloc spends some memory for all allocations to track whether it's free or not and where it was allocated. So there is some (possibly large) multiplier of memory used by your app spent on tracking memory.
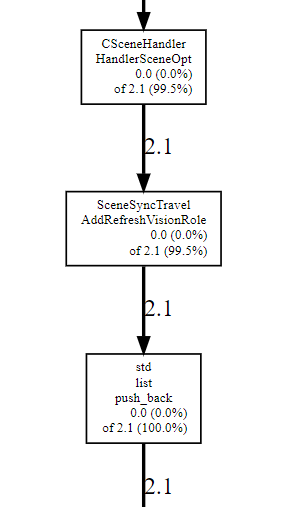
最终在zonesvr只有6000节点的情况下进行协议压测,每分钟dump进程的heap使用情况,然后通过gperftools提供的pprof工具,将不同时间段的dump下来的进程heap使用情况进行对比,就很方便的知道内存泄漏在哪里了,需如下图是1小时的差距,最终发现时泄漏在一个场景操作的列表中。
评论